إلى أي مدى يمكننا دفع حدود وحدة المعالجة المركزية (CPU)؟
لا تكتفِ بأطر العمل المتضخمة والاعتماد على GPU. اكتشف pdefa — محرك استدلال مبني من الصفر يشغّل نماذج التعلم العميق مباشرة على CPU.
إلى أي مدى يمكننا دفع حدود وحدة المعالجة المركزية (CPU)؟
لسنوات، كانت الإجابة عن "تشغيل التعلم العميق" هي نفسها: اشترِ وحدة معالجة رسومات (GPU). لكن هذه الإجابة تتجاهل سؤالاً جوهرياً — كم من هذه العتاد نستخدمه فعلاً، وكم نهدره على أعباء إطار العمل؟
للتحرر من البرمجيات المتضخمة للمكتبات الخارجية وتسخير كامل قوة العتاد بأقصى كفاءة، أشارك رحلتي الهندسية ومشروعي مفتوح المصدر: pdefa (hasnard/pdefa).
ما هو pdefa؟
pdefa هو محرك استدلال للتعلم العميق بنيته من الصفر باستخدام C++20 وبنية AVX2 SIMD لتشغيل النماذج مباشرة على وحدة المعالجة المركزية — لا حاجة إلى GPU، لا وقت تشغيل ثقيل، لا شجرة تبعيات يجب فك تشابكها قبل تشغيل استدلال واحد.
كان دافعي الأساسي بسيطاً: تجربة كيف يمكن إدارة موارد النظام بكفاءة مطلقة، وجلب هذه البنية فائقة الخفة إلى النظام البيئي تحت رخصة AGPL-3.0، مع البقاء بلا تنازلات مخلصاً لفلسفة المصادر المفتوحة الحقيقية.
لماذا نتكبد عناء الاستدلال على CPU أصلاً؟
لأن معظم عمليات النشر في العالم الحقيقي لا تملك رفاهية GPU مخصص. الأجهزة الطرفية، الأنظمة المدمجة، خطوط CI، حالات VPS الصغيرة، آلات أرض المصنع، والعناقيد الأكاديمية كلها تعمل على CPUs. في تلك البيئات، كل ميغابايت من أعباء إطار العمل وكل تبعية غير ضرورية هي تكلفة — في الذاكرة، في وقت البدء، في تعقيد النشر.
إطار عمل بحجم 300 ميغابايت يجلب اثنتي عشرة مكتبة مشتركة ليس "مجانياً". إنه ضريبة تدفعها في كل عملية نشر.
أبرز النقاط التقنية:
- حجم فائق الخفة
الملف الثنائي الأصلي المترجم هو فقط 320 كيلوبايت. لا ميغابايتات من التضخم، لا وقت تشغيل يجب تثبيته أولاً — فقط ما يلزم لتشغيل الاستدلال.
- صفر تبعيات خارجية
واجهة Python تعتمد فقط على وحدة ctypes المدمجة. لا pip install، لا تعارضات إصدارات، لا جمباز بيئات افتراضية.
- تحسين العتاد
يزيد إلى أقصى حد قدرة المعالجة المتجهة باستخدام مجموعات تعليمات AVX2 ويمنح تحكماً مباشراً في عدد الخيوط — حتى تتمكن من ضبطه على CPU التي تعمل عليها بالضبط.
- دعم واسع للبنى
قادر على تشغيل YOLO (من v8 إلى v12)، وResNet، وMobileNet، وEfficientNet، وDeepLabV3 مباشرة.
- معالجة صور مدمجة
يتميز بمحمل PNG/JPEG خاص به وخوارزمية معالجة لاحقة YOLO مدمجة، متجاوزاً تماماً الحاجة إلى مكتبات ثقيلة مثل OpenCV.
- سير عمل تحويل مرن
صدّر نماذج PyTorch الموجودة لديك إلى تنسيق ONNX القياسي، ثم استخدم المحول المدمج في المحرك لترجمتها بسلاسة إلى تنسيق .engine المخصص منخفض الكمون الخاص بـ pdefa.
خارطة طريق التطوير:
سأصدر قريباً أداة pytorchtoengine، التي ستسمح لمستخدمي PyTorch بتجاوز خطوة ONNX الوسيطة تماماً وتحويل النماذج مباشرة إلى التنسيق الأصلي للمحرك. قفزة أقل، شيء أقل لتصحيحه.
لمن هذا:
آمل أن يكون هذا بديلاً قوياً للمطورين الذين يعملون مع خوادم محدودة الموارد، أو أجهزة طرفية، أو أنظمة خفيفة — أي شخص فكر يوماً: "أحتاج فقط لتشغيل هذا النموذج، لا أحتاج نظاماً بيئياً كاملاً من أجله."
إلى أين من هنا:
المستودع مفتوح. التعليقات على بنية الكود مرحب بها بصدق — خاصة من الأشخاص الذين بنوا أنظمة مماثلة أو اصطدموا بنفس الجدران. وإذا لمس هذا وتراً لديك، فإن نجمة تساعد كثيراً في دعم المشروع.
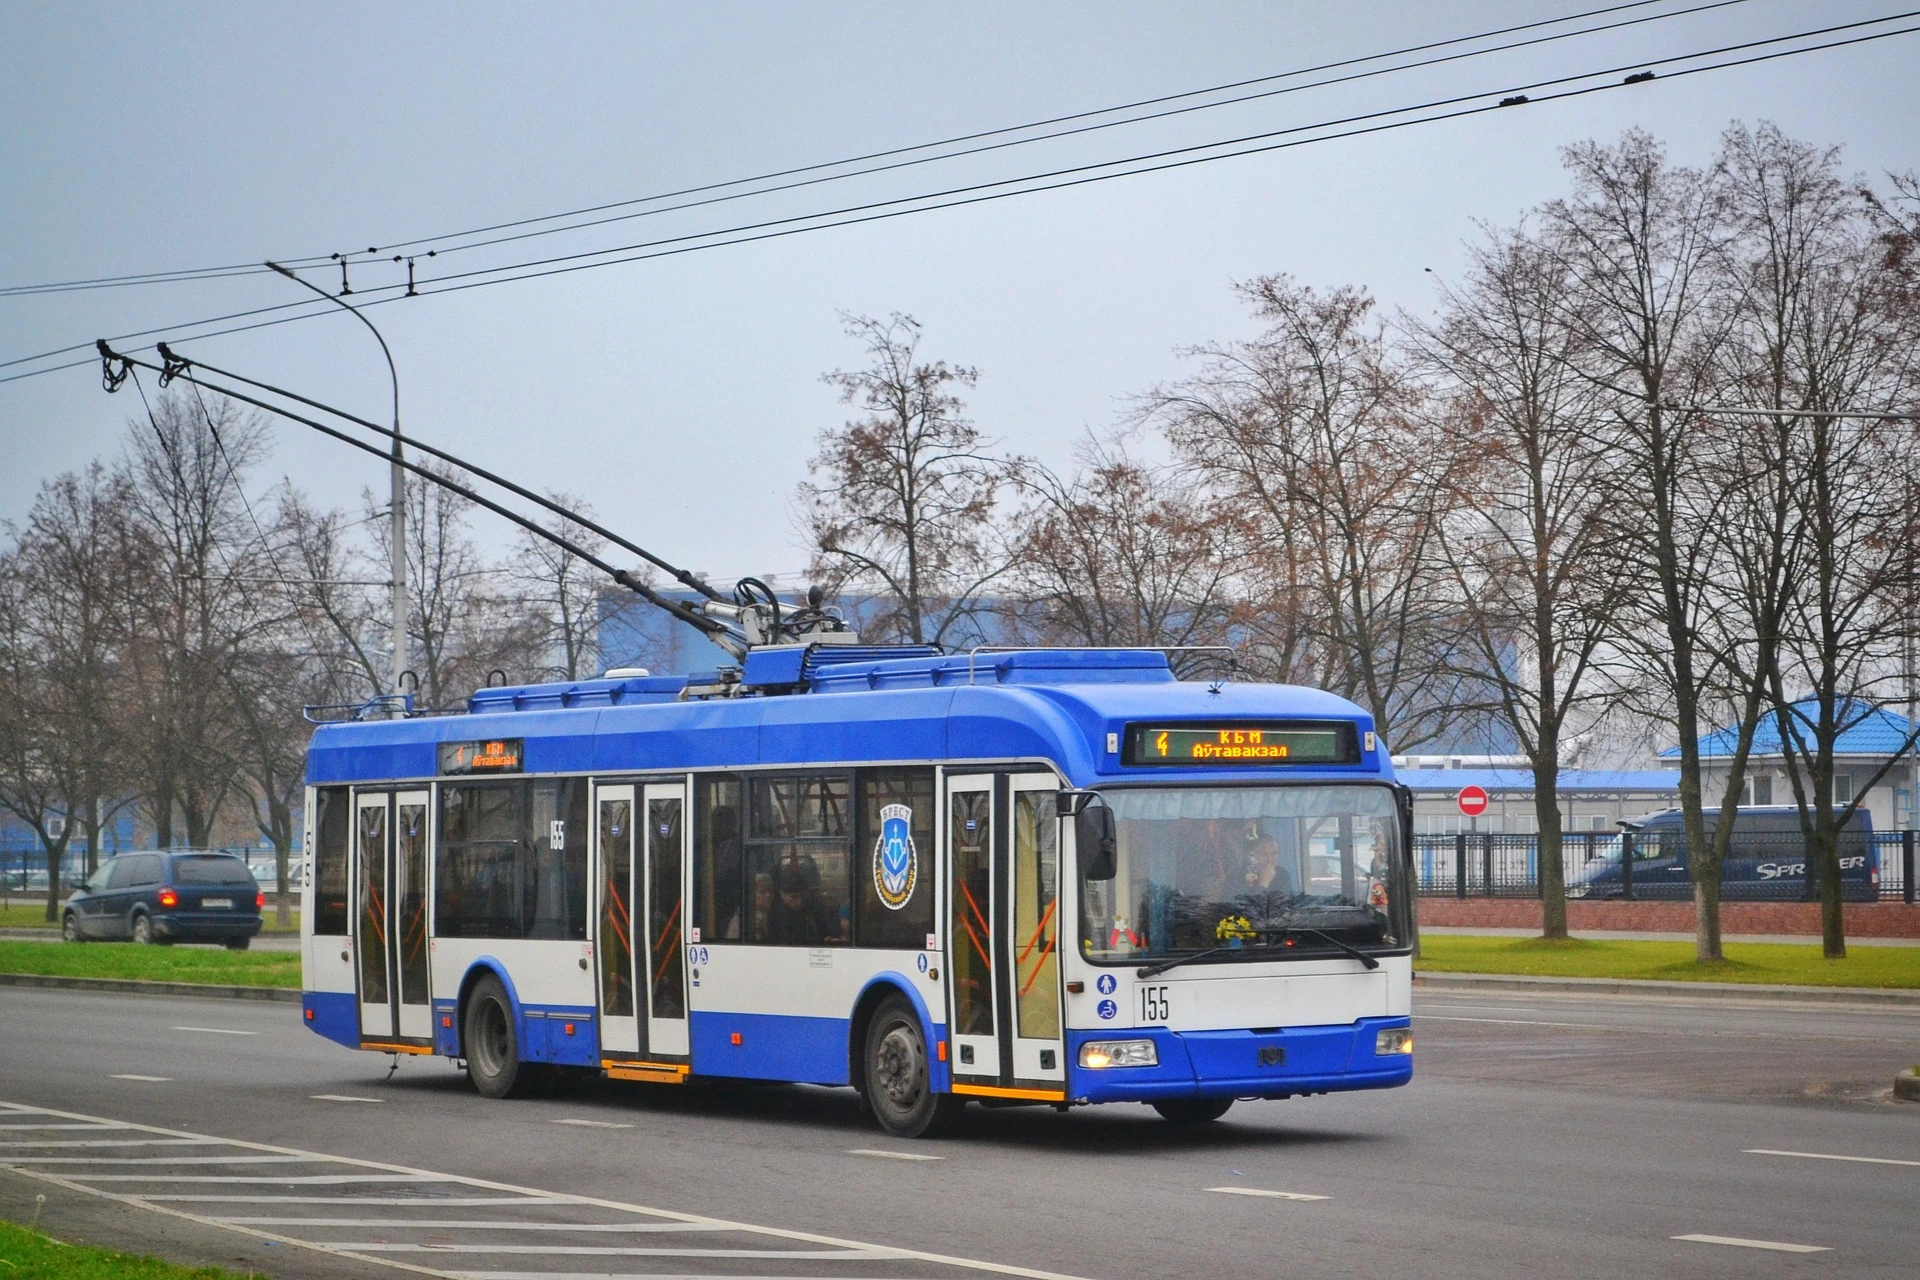
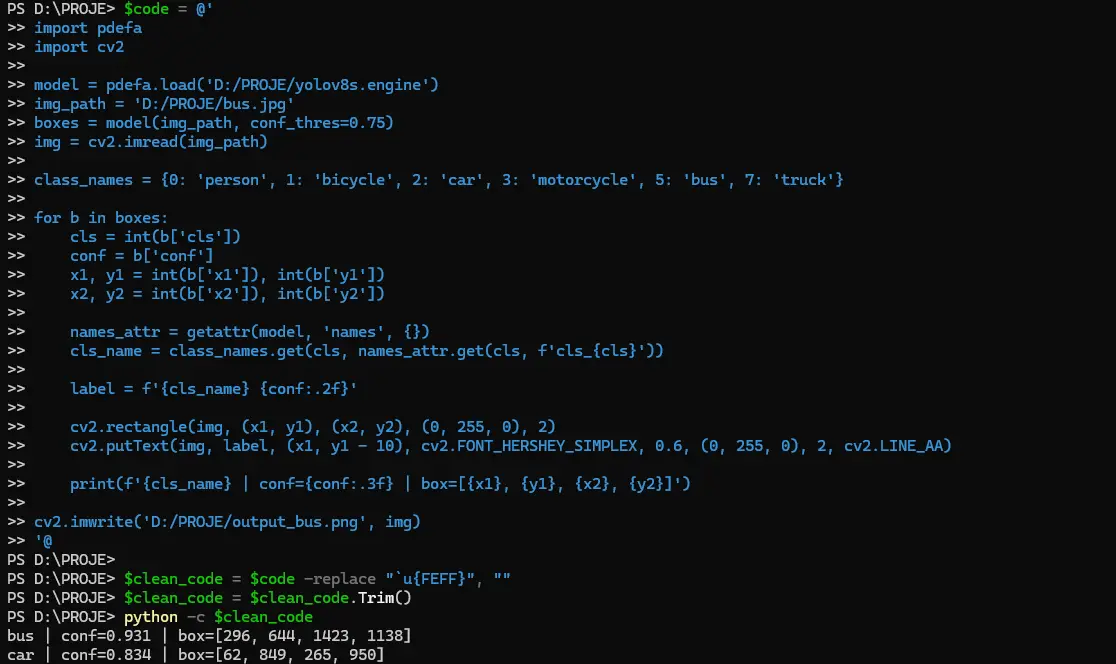
$code = @'
 import pdefa
 import cv2

 model = pdefa.load('D:/PROJE/yolov8s.engine')
 img_path = 'D:/PROJE/bus.jpg'
 boxes = model(img_path, conf_thres=0.75)
 img = cv2.imread(img_path)

 class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}

 for b in boxes:
    cls = int(b['cls'])
    conf = b['conf']
    x1, y1 = int(b['x1']), int(b['y1'])
    x2, y2 = int(b['x2']), int(b['y2'])

    names_attr = getattr(model, 'names', {})
    cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

    label = f'{cls_name} {conf:.2f}'

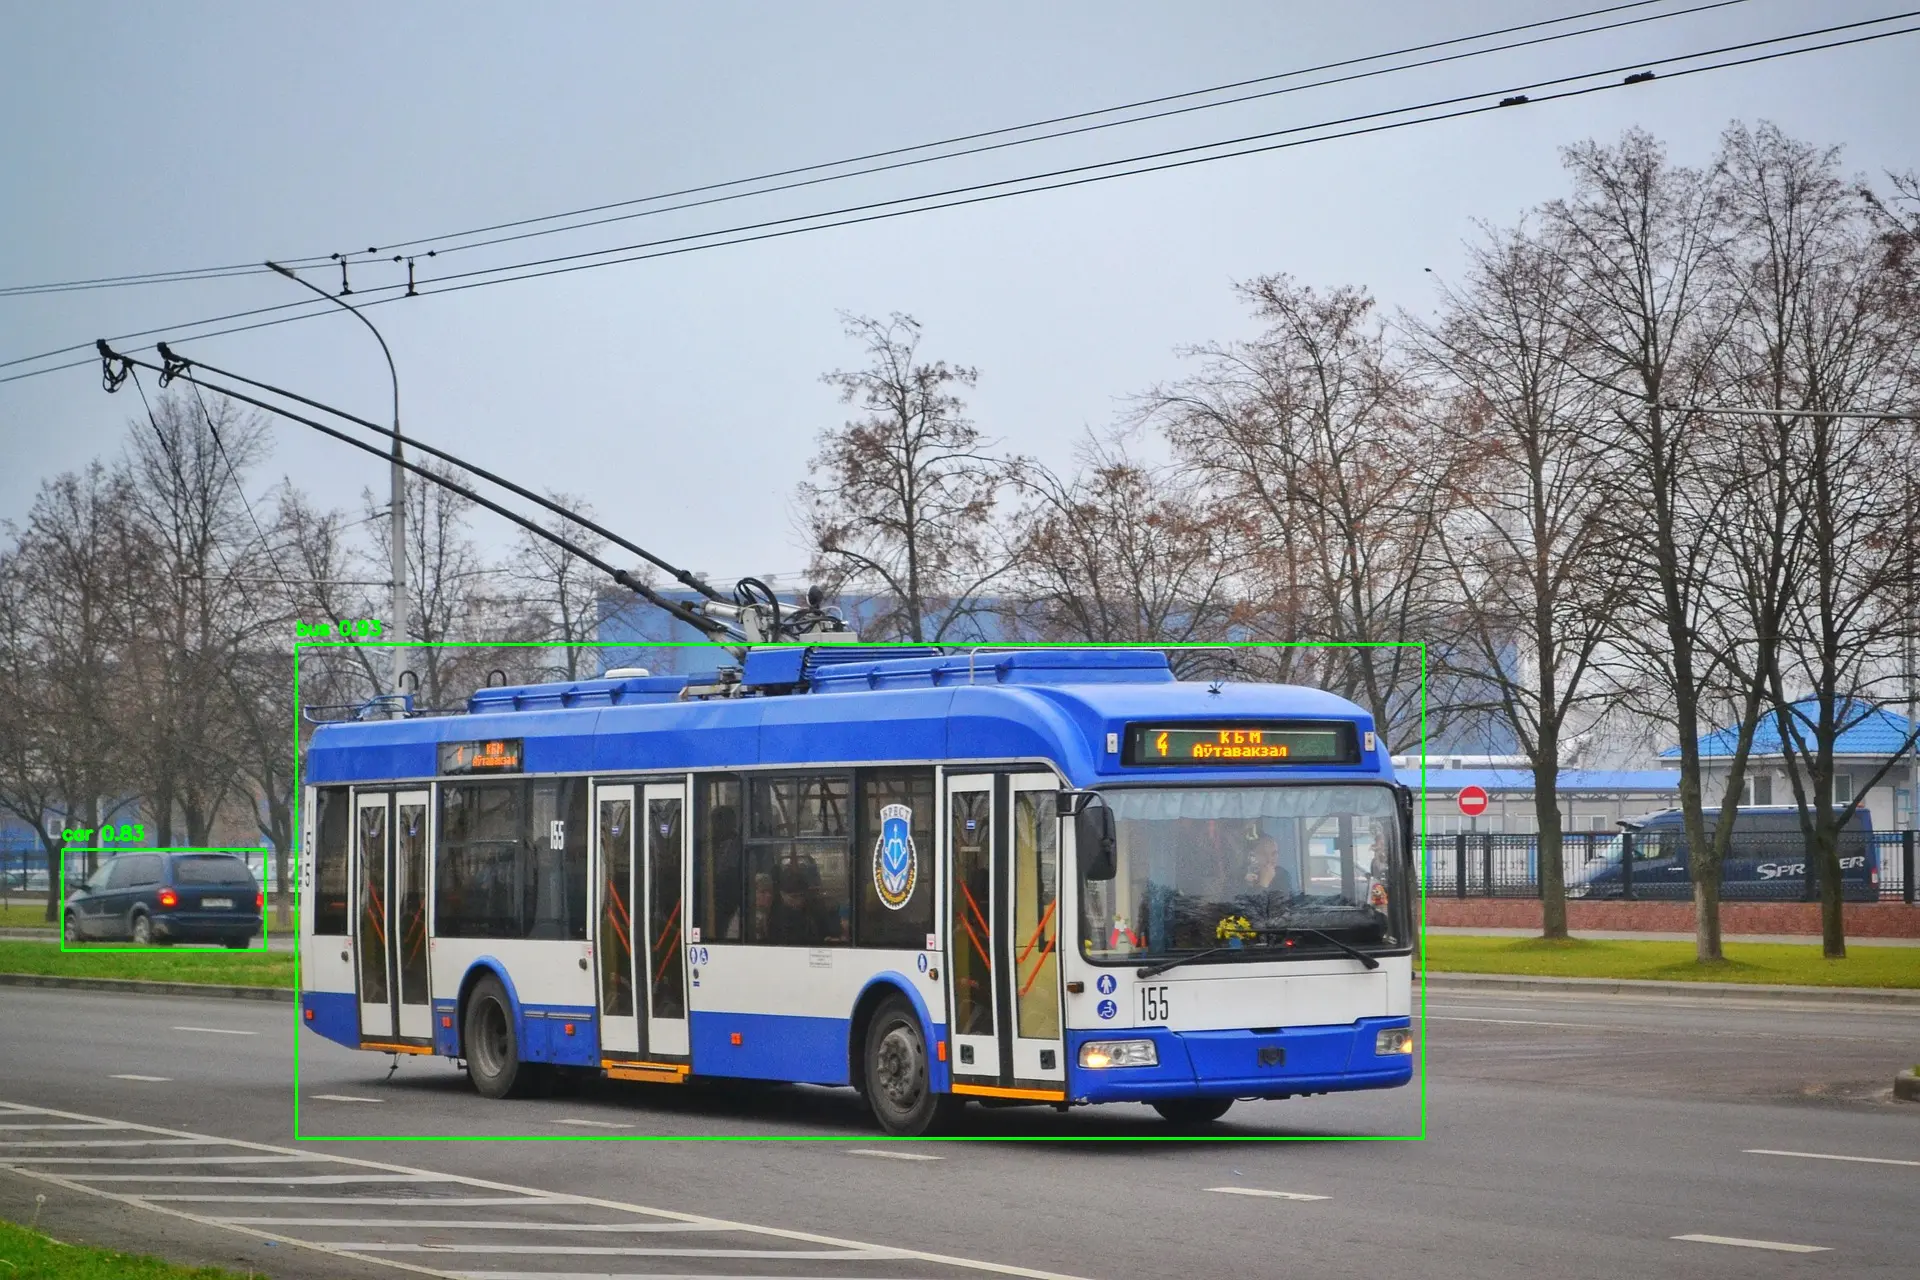
   cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
   cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)

print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')

cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
مرحبًا
سجّل الدخول لاستخدام مساعد الذكاء الاصطناعي
القائمة
الرئيسية
جميع الأدوات
المحرر
تحرير النصوص والأشكال
مدونة
نصائح وأدلة
بحث
أوراق ودراسات أكاديمية
المظهر
اللغة
الإجراءات الأخيرة
Lokal Geçmiş