Wie weit können wir die Grenzen einer CPU ausreizen?
Geben Sie sich nicht mit aufgeblähten Frameworks und GPU-Abhängigkeit zufrieden. Entdecken Sie pdefa — eine von Grund auf entwickelte Inferenz-Engine, die Deep-Learning-Modelle direkt auf der CPU ausführt.
Wie weit können wir die Grenzen einer CPU ausreizen?
Jahrelang war die Antwort auf „Deep Learning ausführen“ dieselbe: Kauf eine GPU. Doch diese Antwort ignoriert eine grundlegende Frage – wie viel dieser Hardware nutzen wir tatsächlich, und wie viel verschwenden wir für Framework-Overhead?
Um uns von der Bloatware externer Bibliotheken zu befreien und die volle Leistung der Hardware mit maximaler Effizienz zu nutzen, teile ich meine Engineering-Reise und mein Open-Source-Projekt: pdefa (hasnard/pdefa).
Was ist pdefa?
pdefa ist eine Deep-Learning-Inferenz-Engine, die ich von Grund auf mit C++20 und AVX2-SIMD-Architektur entwickelt habe, um Modelle direkt auf der CPU auszuführen – keine GPU erforderlich, keine schwere Laufzeitumgebung, kein Abhängigkeitsbaum, der entwirrt werden muss, bevor Sie eine einzelne Inferenz ausführen können.
Meine Kernmotivation war einfach: zu erleben, wie Systemressourcen mit absoluter Effizienz verwaltet werden können, und diese ultraleichte Architektur unter der AGPL-3.0-Lizenz in das Ökosystem zu bringen, wobei ich kompromisslos der echten Open-Source-Philosophie treu bleibe.
Warum sich überhaupt mit CPU-Inferenz beschäftigen?
Weil die meisten realen Bereitstellungen nicht den Luxus einer dedizierten GPU haben. Edge-Geräte, eingebettete Systeme, CI-Pipelines, kleine VPS-Instanzen, Maschinen in der Fabrikhalle und akademische Cluster laufen alle auf CPUs. In diesen Umgebungen sind jedes Megabyte Framework-Overhead und jede unnötige Abhängigkeit ein Kostenfaktor – im Speicher, in der Startzeit, in der Bereitstellungskomplexität.
Ein 300 MB großes Framework, das ein Dutzend Shared Libraries einbindet, ist nicht „kostenlos“. Es ist eine Steuer, die Sie bei jeder Bereitstellung zahlen.
Wichtige technische Highlights:
- Ultraleichte Größe
Die kompilierte native Binärdatei ist nur 320 KB groß. Keine Megabyte an Ballast, keine Laufzeitumgebung, die zuerst installiert werden muss – nur das, was zum Ausführen der Inferenz benötigt wird.
- Null externe Abhängigkeiten
Die Python-Schnittstelle stützt sich ausschließlich auf das integrierte ctypes-Modul. Kein pip install, keine Versionskonflikte, keine Virtual-Environment-Akrobatik.
- Hardware-Optimierung
Maximiert die vektorisierte Verarbeitungskapazität mithilfe von AVX2-Befehlssätzen und ermöglicht die direkte Kontrolle über die Thread-Anzahl – sodass Sie sie genau auf die CPU abstimmen können, auf der Sie arbeiten.
- Breite Architekturunterstützung
Kann YOLO (v8 bis v12), ResNet, MobileNet, EfficientNet und DeepLabV3-Architekturen out of the box ausführen.
- Integrierte Bildverarbeitung
Verfügt über einen eigenen PNG/JPEG-Loader und einen integrierten YOLO-Nachverarbeitungsalgorithmus, wodurch die Notwendigkeit schwerer Bibliotheken wie OpenCV vollständig entfällt.
- Flexibler Konvertierungsworkflow
Exportieren Sie Ihre vorhandenen PyTorch-Modelle in das Standard-ONNX-Format und verwenden Sie dann den integrierten Konverter der Engine, um sie nahtlos in pdefas benutzerdefiniertes, latenzarmes .engine-Format zu übersetzen.
Entwicklungs-Roadmap:
Ich werde bald das Tool pytorchtoengine veröffentlichen, das PyTorch-Nutzern ermöglicht, den ONNX-Zwischenschritt vollständig zu umgehen und Modelle direkt in das native Format der Engine zu konvertieren. Ein Sprung weniger, eine Sache weniger, die debuggt werden muss.
Für wen das gedacht ist:
Ich hoffe, dass dies eine leistungsstarke Alternative für Entwickler ist, die mit ressourcenbeschränkten Servern, Edge-Geräten oder Leichtgewichtssystemen arbeiten – für alle, die jemals gedacht haben: „Ich muss nur dieses Modell ausführen, ich brauche kein ganzes Ökosystem dafür.“
Wie es von hier aus weitergeht:
Das Repository ist offen. Feedback zur Code-Architektur ist wirklich willkommen – besonders von Personen, die ähnliche Systeme gebaut haben oder auf dieselben Hürden gestoßen sind. Und wenn Ihnen das zusagt, hilft ein Stern dem Projekt sehr.
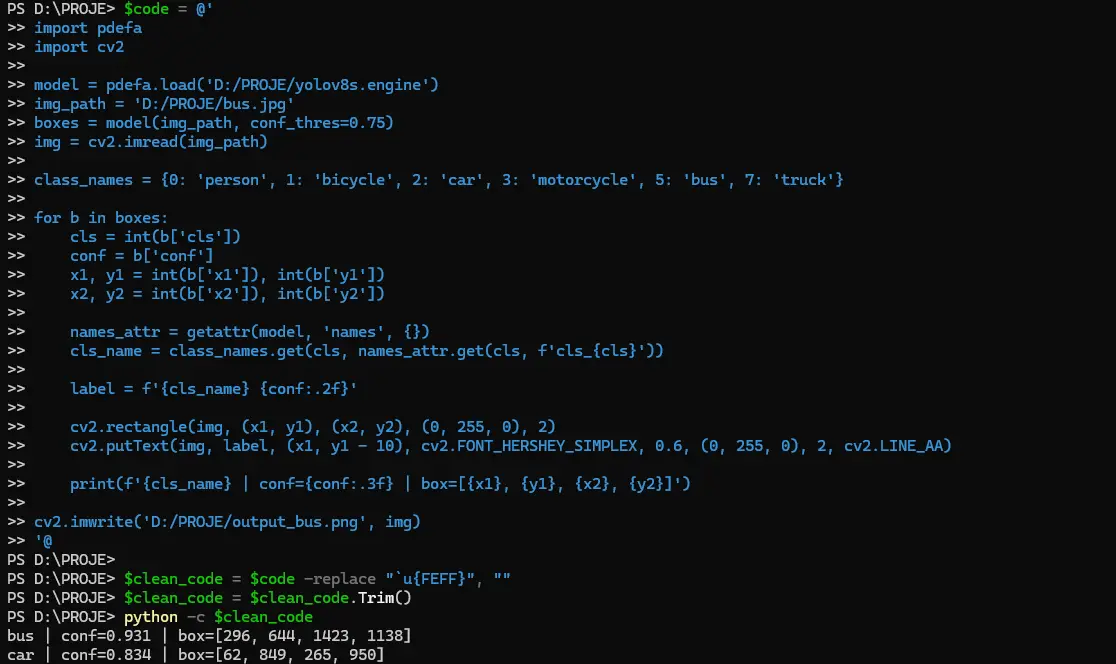
$code = @'
 import pdefa
 import cv2

 model = pdefa.load('D:/PROJE/yolov8s.engine')
 img_path = 'D:/PROJE/bus.jpg'
 boxes = model(img_path, conf_thres=0.75)
 img = cv2.imread(img_path)

 class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}

 for b in boxes:
    cls = int(b['cls'])
    conf = b['conf']
    x1, y1 = int(b['x1']), int(b['y1'])
    x2, y2 = int(b['x2']), int(b['y2'])

    names_attr = getattr(model, 'names', {})
    cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

    label = f'{cls_name} {conf:.2f}'

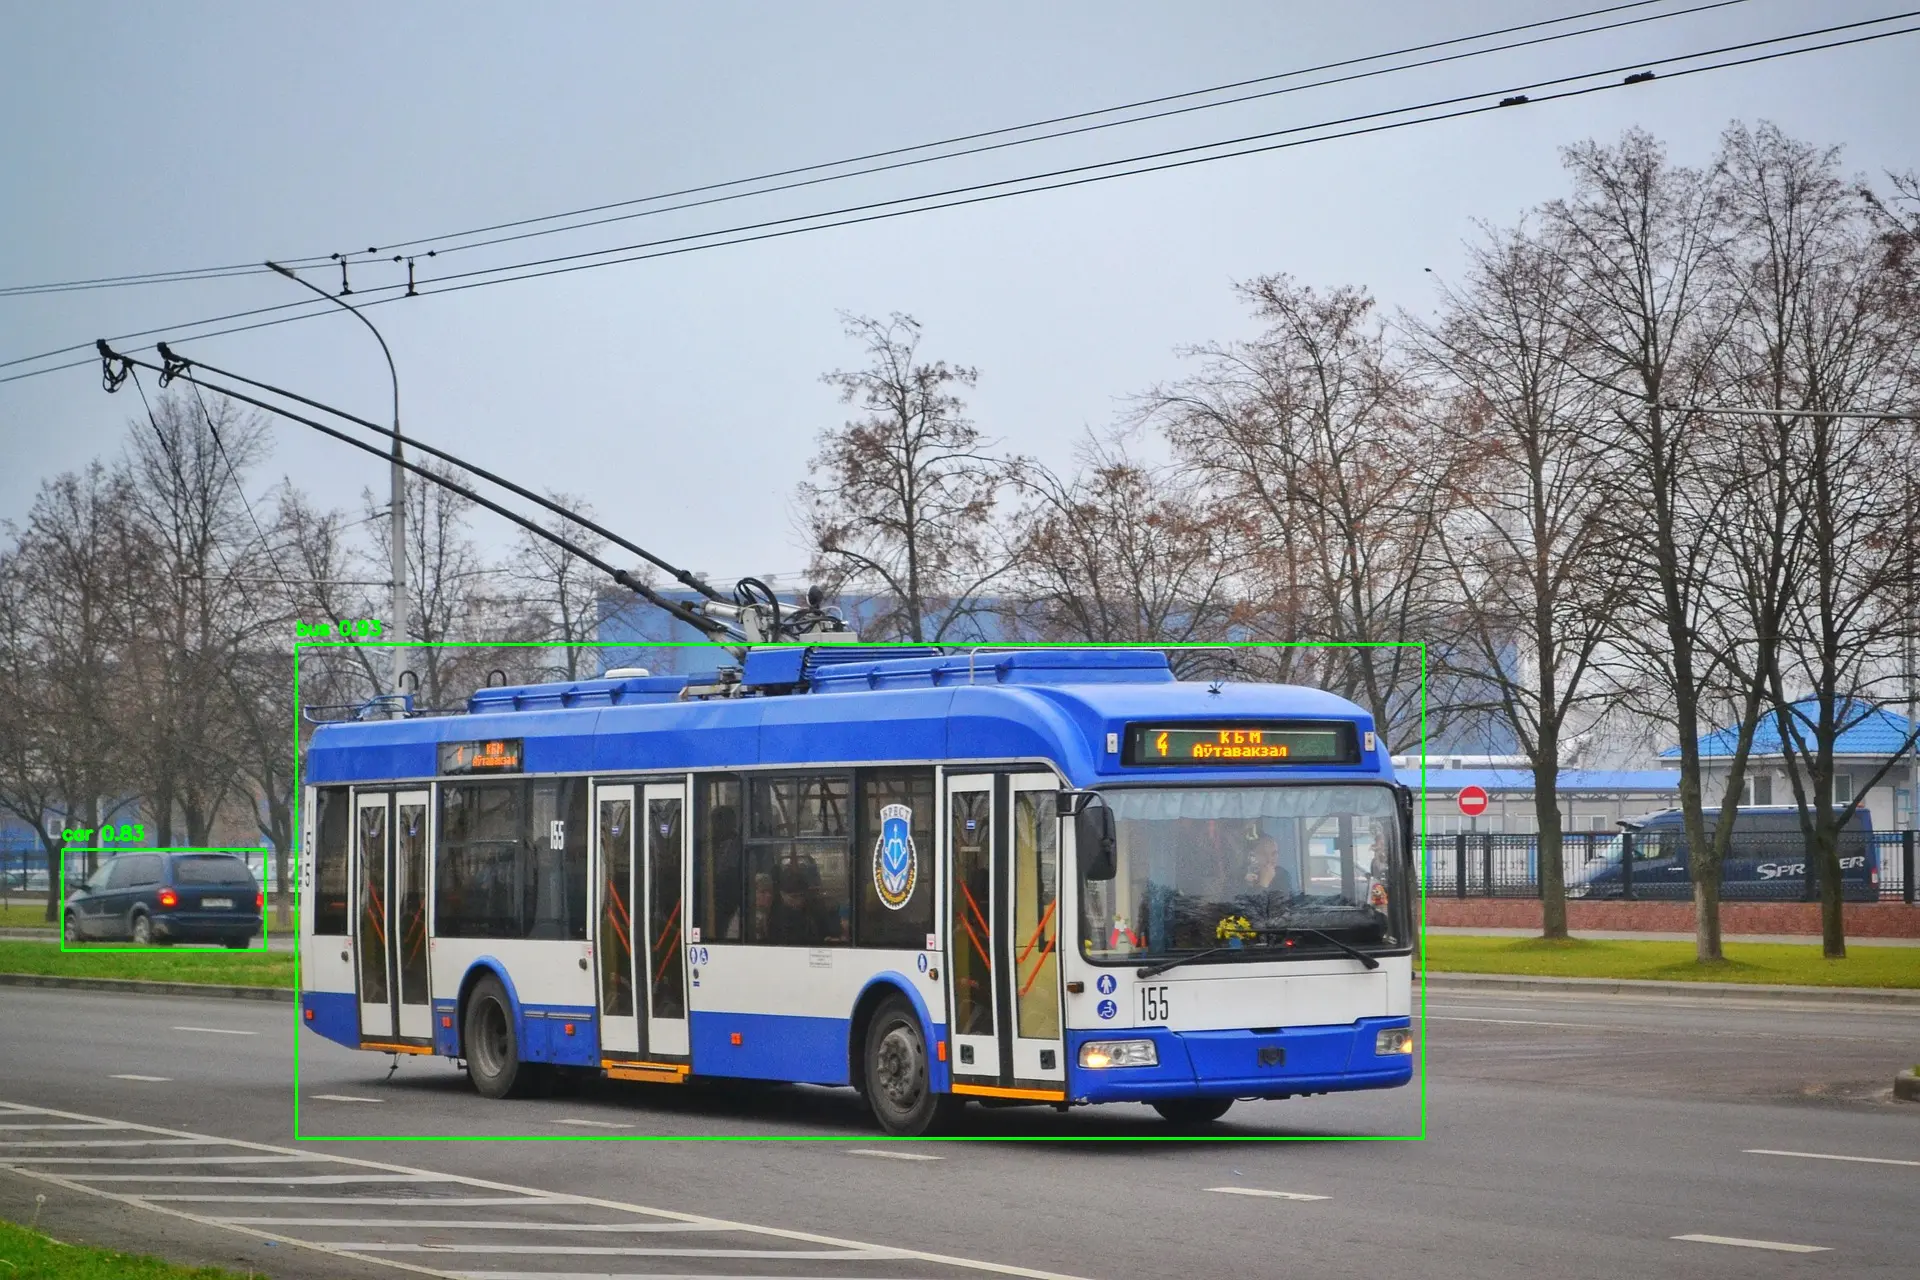
   cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
   cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)

print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')

cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
Das könnte Ihnen auch gefallen
Alle anzeigen
Willkommen
Melden Sie sich an, um den KI-Assistenten zu nutzen
Menu
Startseite
All tools
Editor
Edit text & shapes
Blog
Tips & guides
Forschung
Akademische Arbeiten & Studien
Dark Mode
Language
Letzte Aktionen
Lokal Geçmiş