¿Hasta dónde podemos llevar los límites de una CPU?
No te conformes con frameworks inflados y dependencia de GPU. Descubre pdefa — un motor de inferencia creado desde cero que ejecuta modelos de aprendizaje profundo directamente en la CPU.
¿Hasta dónde podemos llevar los límites de una CPU?
Durante años, la respuesta a "ejecutar aprendizaje profundo" ha sido la misma: compra una GPU. Pero esa respuesta ignora una pregunta fundamental: ¿cuánto de ese hardware estamos usando realmente y cuánto estamos desperdiciando en la sobrecarga del framework?
Para liberarnos del bloatware de las bibliotecas externas y aprovechar todo el poder del hardware con la máxima eficiencia, comparto mi viaje de ingeniería y mi proyecto de código abierto: pdefa (hasnard/pdefa).
¿Qué es pdefa?
pdefa es un motor de inferencia de aprendizaje profundo que construí desde cero usando C++20 y arquitectura SIMD AVX2 para ejecutar modelos directamente en la CPU — sin necesidad de GPU, sin runtime pesado, sin árbol de dependencias que desenredar antes de poder ejecutar una sola inferencia.
Mi motivación principal era simple: experimentar cómo se pueden gestionar los recursos del sistema con absoluta eficiencia y llevar esta arquitectura ultraligera al ecosistema bajo la licencia AGPL-3.0, manteniéndome sin concesiones fiel a la verdadera filosofía del código abierto.
¿Por qué molestarse con la inferencia en CPU?
Porque la mayoría de los despliegues del mundo real no tienen el lujo de una GPU dedicada. Los dispositivos de borde, los sistemas embebidos, los pipelines de CI, las pequeñas instancias VPS, las máquinas de planta y los clústeres académicos funcionan todos en CPU. En esos entornos, cada megabyte de sobrecarga del framework y cada dependencia innecesaria es un costo — en memoria, en tiempo de inicio, en complejidad de despliegue.
Un framework de 300 MB que arrastra una docena de bibliotecas compartidas no es "gratis". Es un impuesto que pagas en cada despliegue.
Puntos técnicos destacados:
- Tamaño ultraligero
El binario nativo compilado es de solo 320 KB. Sin megabytes de lastre, sin runtime que tengas que instalar primero — solo lo necesario para ejecutar la inferencia.
- Cero dependencias externas
La interfaz de Python se basa únicamente en el módulo ctypes integrado. Sin pip install, sin conflictos de versiones, sin gimnasia de entornos virtuales.
- Optimización de hardware
Maximiza la capacidad de procesamiento vectorizado usando conjuntos de instrucciones AVX2 y da control directo sobre el número de hilos — para que puedas ajustarlo exactamente a la CPU en la que estás ejecutando.
- Amplio soporte de arquitecturas
Capaz de ejecutar YOLO (v8 a v12), ResNet, MobileNet, EfficientNet y DeepLabV3 de fábrica.
- Procesamiento de imágenes integrado
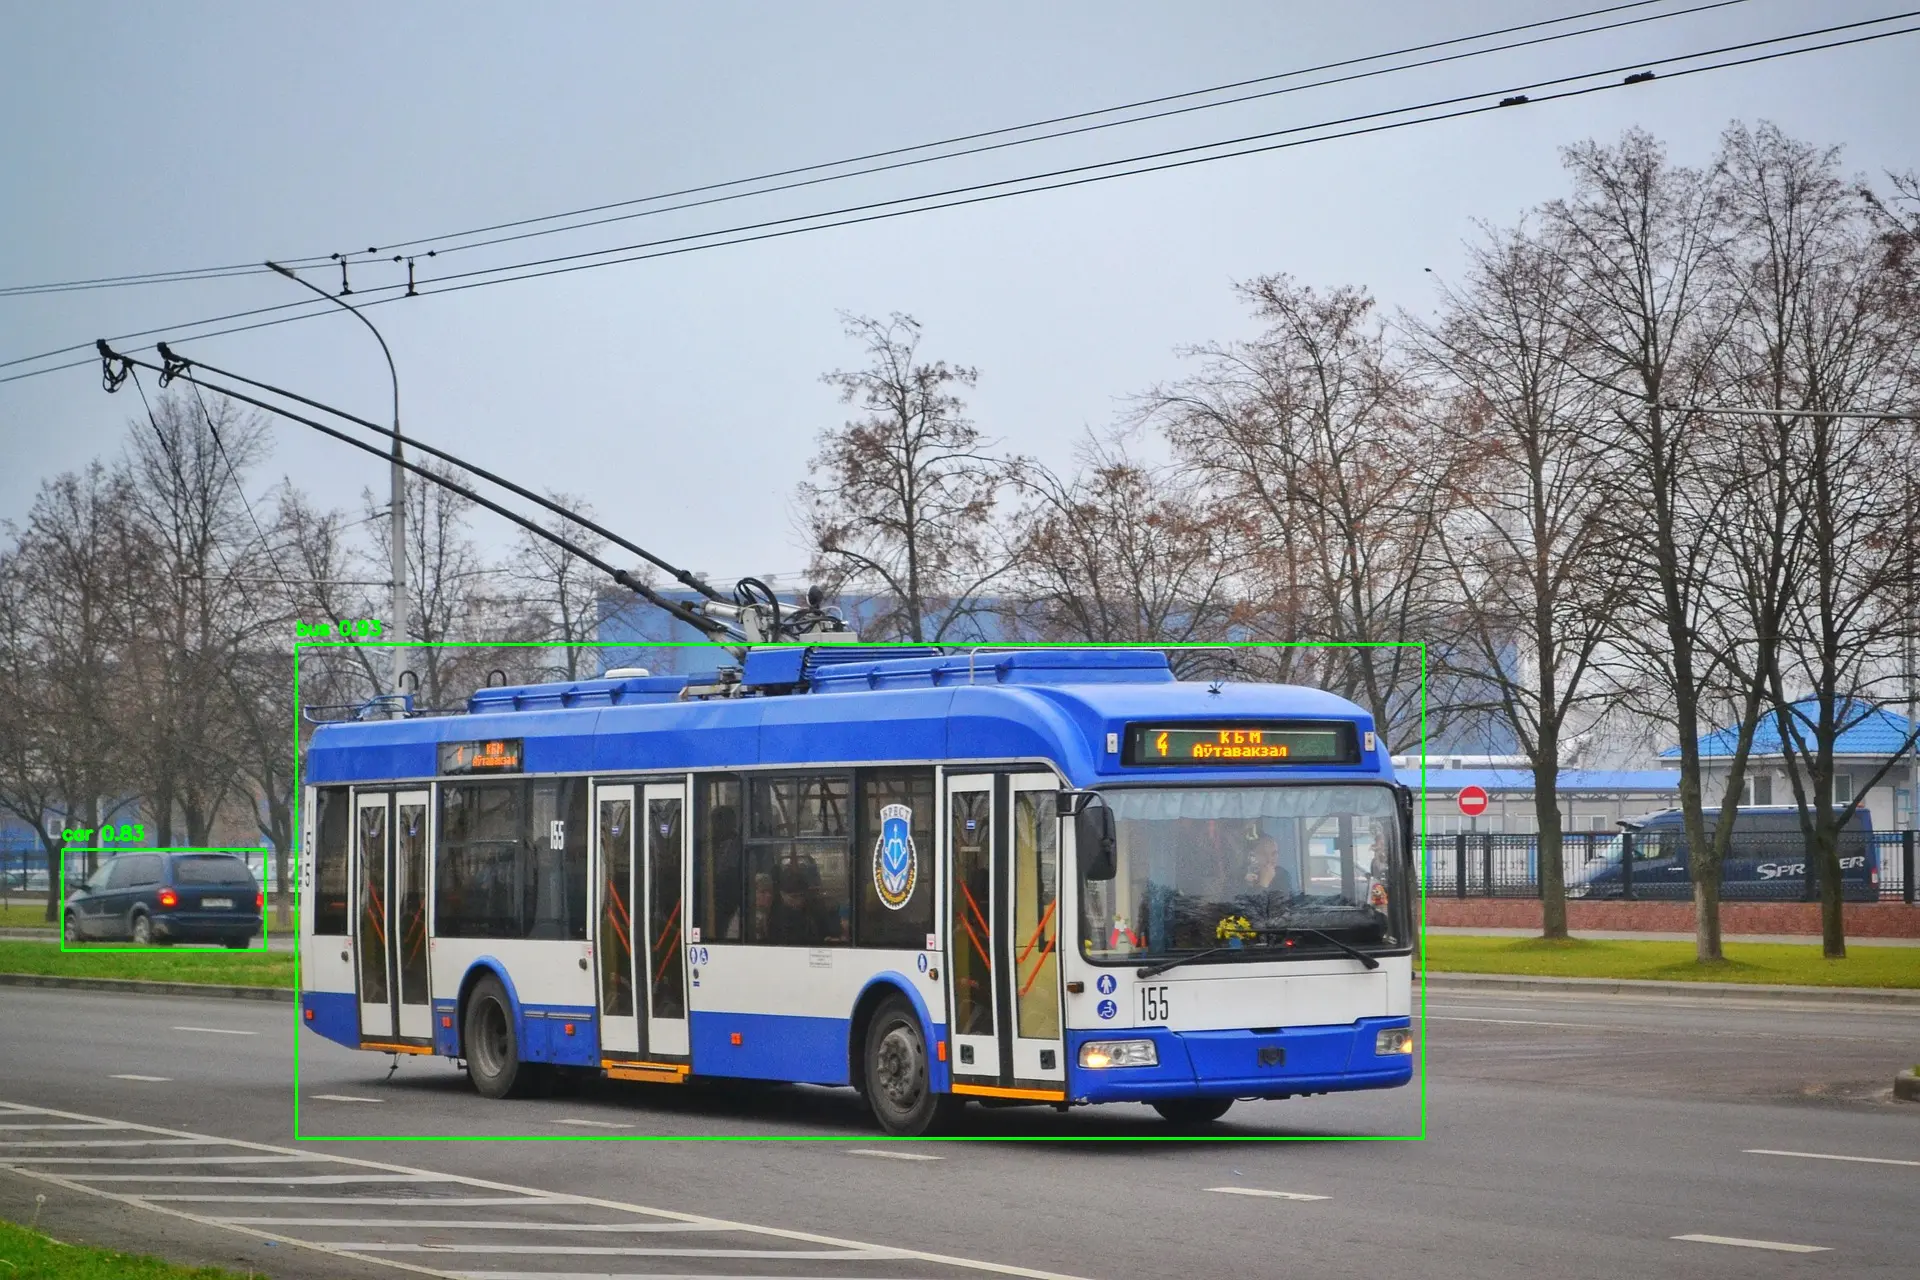
Cuenta con su propio cargador PNG/JPEG y un algoritmo de postprocesamiento YOLO integrado, evitando por completo la necesidad de bibliotecas pesadas como OpenCV.
- Flujo de conversión flexible
Exporta tus modelos PyTorch existentes al formato ONNX estándar y luego usa el convertidor integrado del motor para traducirlos sin problemas al formato .engine personalizado de baja latencia de pdefa.
Hoja de ruta de desarrollo:
Pronto lanzaré la herramienta pytorchtoengine, que permitirá a los usuarios de PyTorch omitir por completo el paso intermedio de ONNX y convertir modelos directamente al formato nativo del motor. Un salto menos, una cosa menos que depurar.
Para quién es esto:
Espero que esto sirva como una alternativa poderosa para desarrolladores que trabajan con servidores con recursos limitados, dispositivos de borde o sistemas ligeros — cualquiera que alguna vez haya pensado: "Solo necesito ejecutar este modelo, no necesito todo un ecosistema para ello".
A dónde ir desde aquí:
El repositorio está abierto. Los comentarios sobre la arquitectura del código son genuinamente bienvenidos — especialmente de personas que hayan construido sistemas similares o se hayan topado con los mismos muros. Y si esto resuena contigo, una estrella ayuda mucho a apoyar el proyecto.
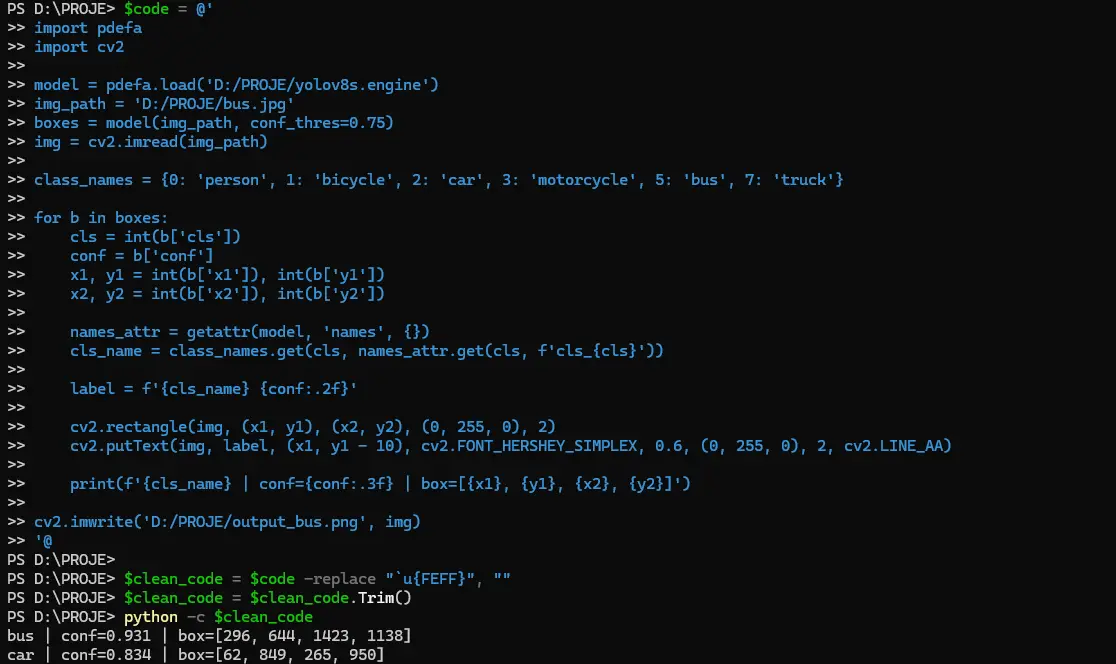
$code = @'
 import pdefa
 import cv2

 model = pdefa.load('D:/PROJE/yolov8s.engine')
 img_path = 'D:/PROJE/bus.jpg'
 boxes = model(img_path, conf_thres=0.75)
 img = cv2.imread(img_path)

 class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}

 for b in boxes:
    cls = int(b['cls'])
    conf = b['conf']
    x1, y1 = int(b['x1']), int(b['y1'])
    x2, y2 = int(b['x2']), int(b['y2'])

    names_attr = getattr(model, 'names', {})
    cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

    label = f'{cls_name} {conf:.2f}'

   cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
   cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)

print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')

cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
Bienvenido
Inicia sesión para usar el asistente de IA
Menú
Inicio
Todas las herramientas
Editor
Editar texto y formas
Blog
Consejos y guías
Investigación
Artículos y estudios académicos
Tema
Idioma
Acciones recientes
Lokal Geçmiş