Fino a che punto possiamo spingere i limiti di una CPU?
Non accontentarti di framework gonfi e dipendenza dalla GPU. Scopri pdefa — un motore di inferenza creato da zero che esegue modelli di deep learning direttamente sulla CPU.
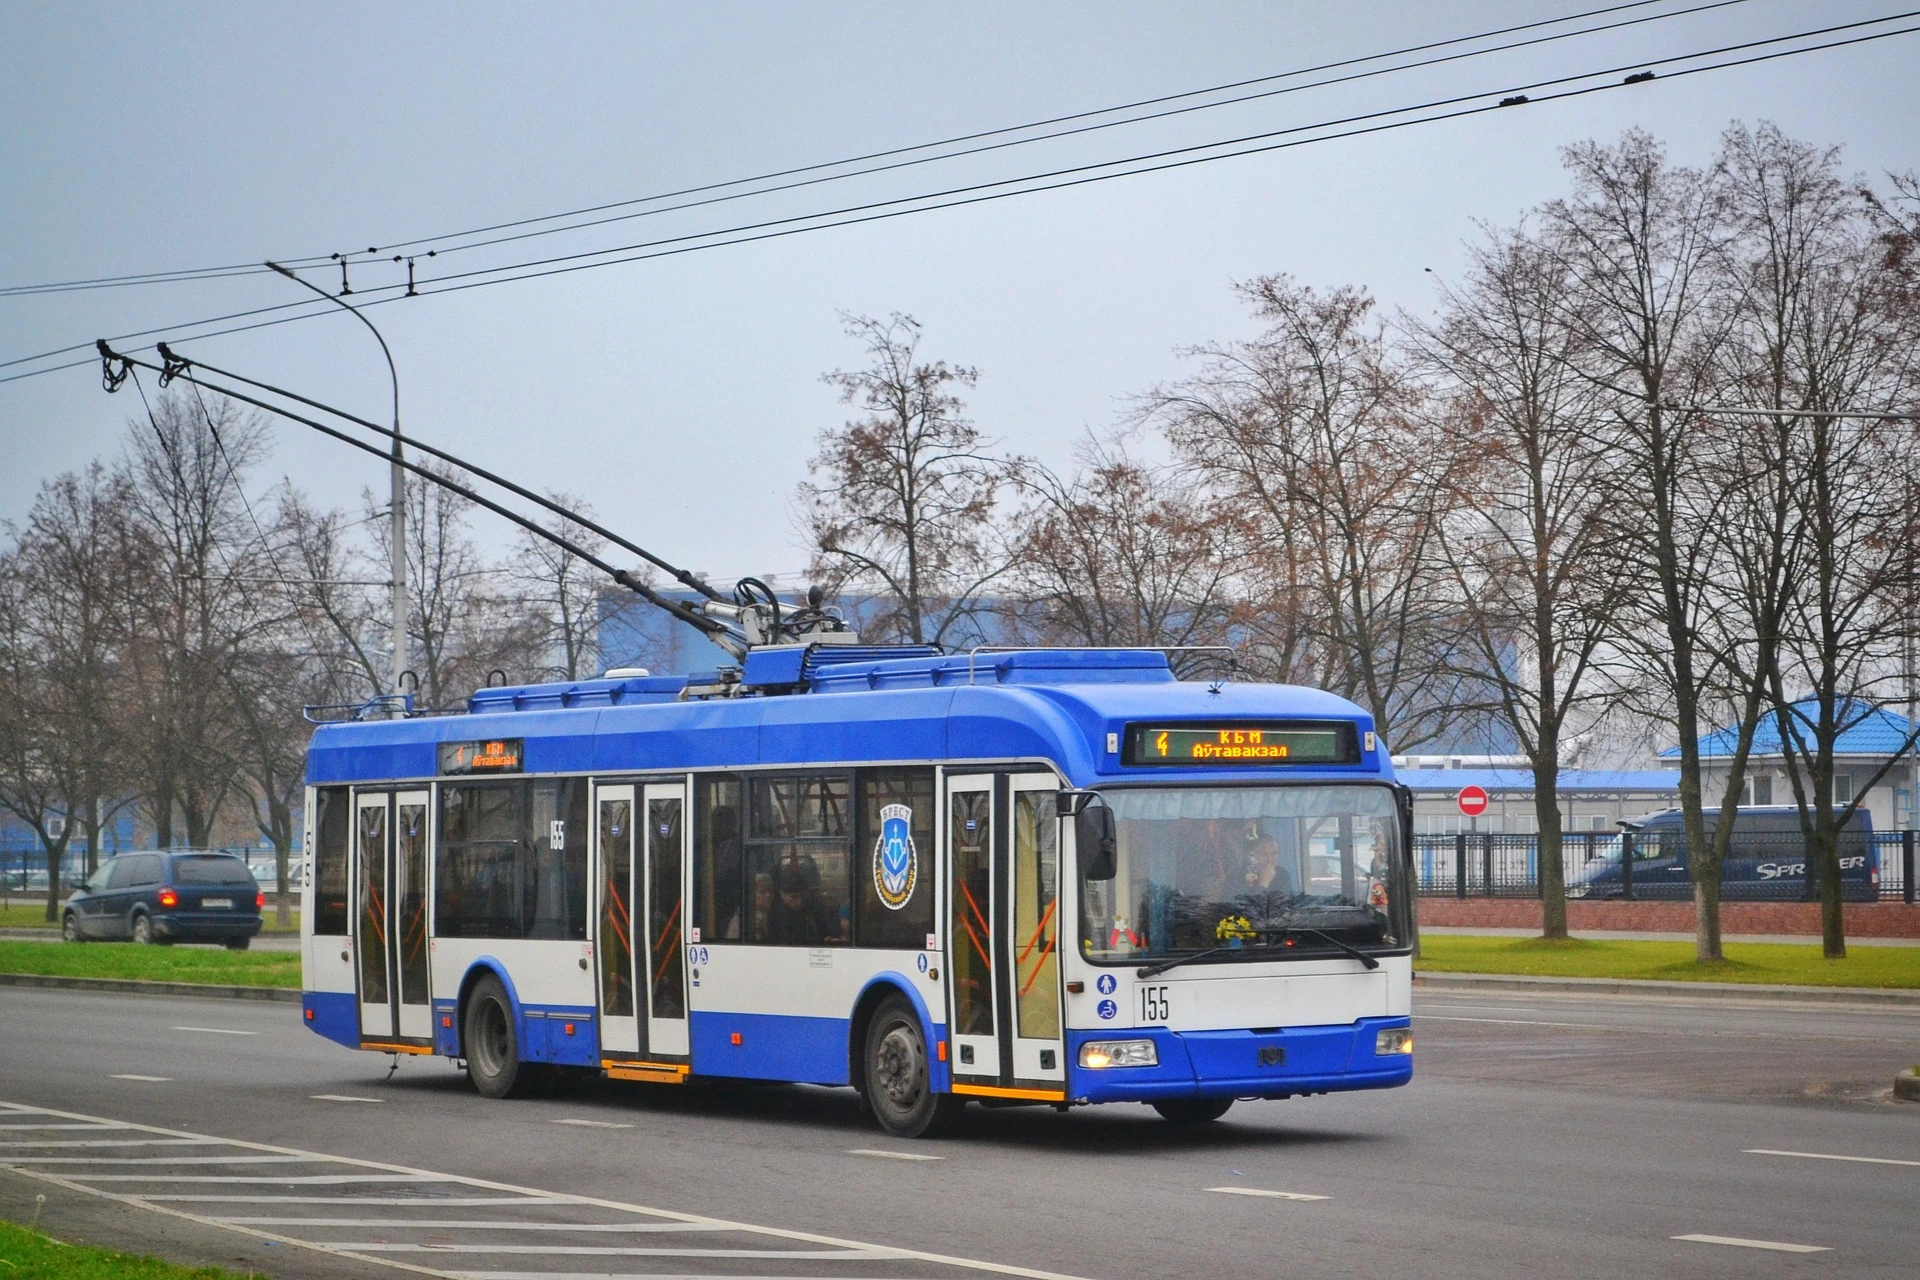
Fino a che punto possiamo spingere i limiti di una CPU?
Per anni, la risposta a "eseguire deep learning" è stata la stessa: compra una GPU. Ma questa risposta ignora una domanda fondamentale — quanto di quell'hardware stiamo effettivamente usando e quanto stiamo sprecando in overhead del framework?
Per liberarci dal bloatware delle librerie esterne e sfruttare tutta la potenza dell'hardware con la massima efficienza, condivido il mio percorso ingegneristico e il mio progetto open source: pdefa (hasnard/pdefa).
Cos'è pdefa?
pdefa è un motore di inferenza per deep learning che ho costruito da zero usando C++20 e architettura SIMD AVX2 per eseguire modelli direttamente sulla CPU — nessuna GPU richiesta, nessun runtime pesante, nessun albero di dipendenze da districare prima di poter eseguire una singola inferenza.
La mia motivazione principale era semplice: sperimentare come le risorse di sistema possono essere gestite con assoluta efficienza e portare questa architettura ultraleggera nell'ecosistema sotto licenza AGPL-3.0, rimanendo senza compromessi fedele alla vera filosofia open source.
Perché preoccuparsi dell'inferenza su CPU?
Perché la maggior parte dei deployment reali non ha il lusso di una GPU dedicata. Dispositivi edge, sistemi embedded, pipeline CI, piccole istanze VPS, macchine di fabbrica e cluster accademici funzionano tutti su CPU. In quegli ambienti, ogni megabyte di overhead del framework e ogni dipendenza non necessaria è un costo — in memoria, in tempo di avvio, in complessità di deployment.
Un framework da 300 MB che tira dentro una dozzina di librerie condivise non è "gratuito". È una tassa che paghi su ogni deployment.
Punti tecnici salienti:
- Dimensioni ultraleggere
Il binario nativo compilato è di soli 320 KB. Niente megabyte di zavorra, nessun runtime da installare prima — solo ciò che serve per eseguire l'inferenza.
- Zero dipendenze esterne
L'interfaccia Python si basa unicamente sul modulo ctypes integrato. Niente pip install, niente conflitti di versione, niente ginnastica di ambienti virtuali.
- Ottimizzazione hardware
Massimizza la capacità di elaborazione vettoriale usando set di istruzioni AVX2 e offre controllo diretto sul numero di thread — così puoi regolarlo esattamente sulla CPU su cui stai girando.
- Ampio supporto di architetture
Capace di eseguire YOLO (da v8 a v12), ResNet, MobileNet, EfficientNet e DeepLabV3 out of the box.
- Elaborazione immagini integrata
Dispone di un proprio loader PNG/JPEG e di un algoritmo di post-processing YOLO integrato, bypassando completamente la necessità di librerie pesanti come OpenCV.
- Flusso di conversione flessibile
Esporta i tuoi modelli PyTorch esistenti nel formato standard ONNX, poi usa il convertitore integrato del motore per tradurli senza problemi nel formato .engine personalizzato a bassa latenza di pdefa.
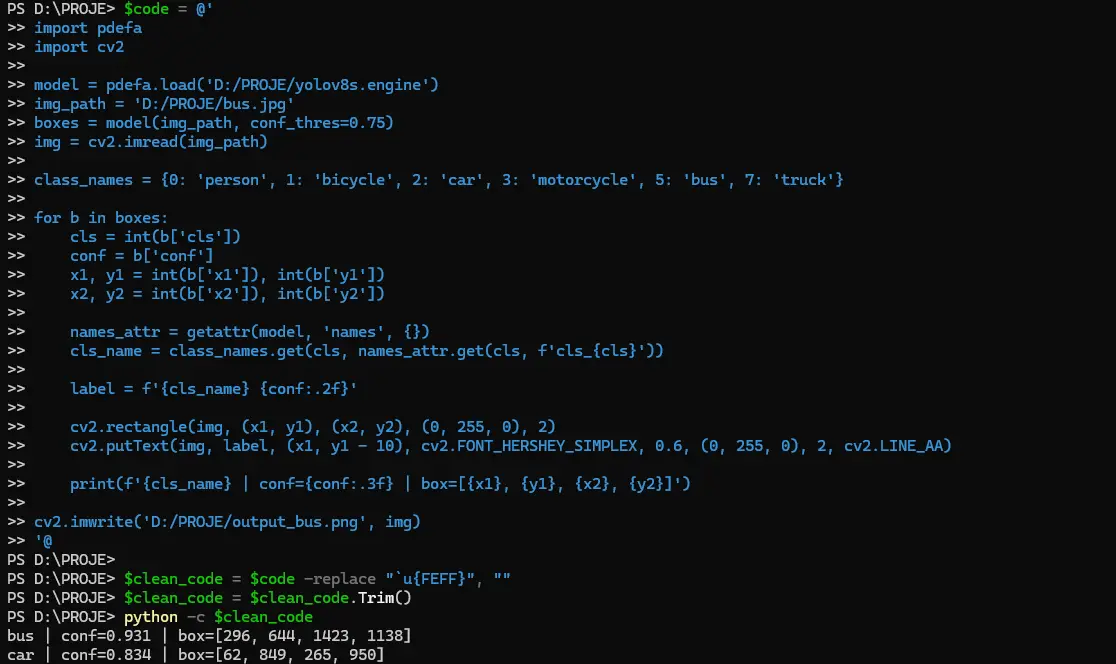
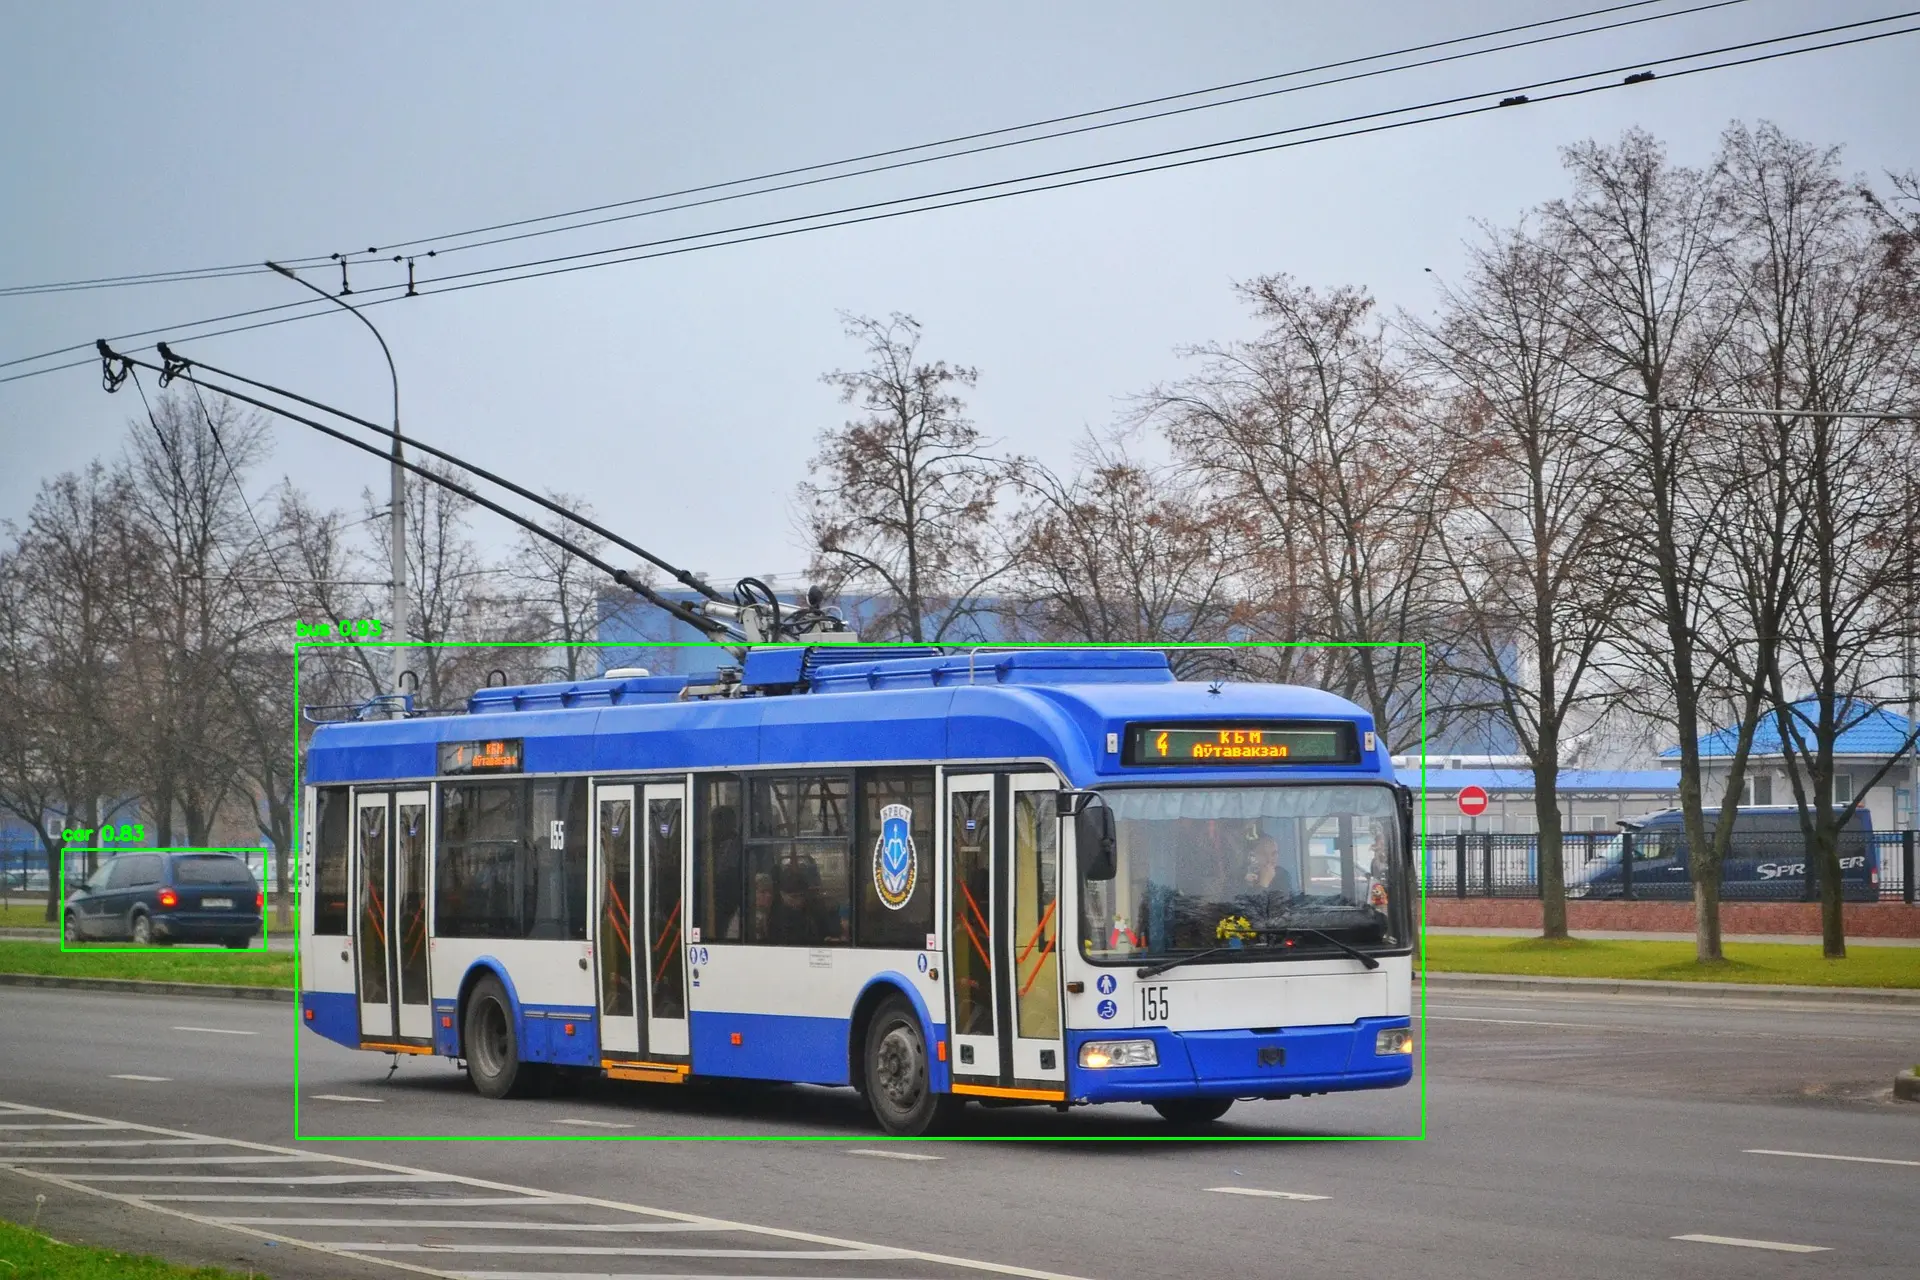
Roadmap di sviluppo:
Presto rilascerò lo strumento pytorchtoengine, che permetterà agli utenti PyTorch di bypassare completamente il passaggio intermedio ONNX e convertire i modelli direttamente nel formato nativo del motore. Un salto in meno, una cosa in meno da debuggare.
A chi è rivolto:
Spero che questo serva come una potente alternativa per gli sviluppatori che lavorano con server a risorse limitate, dispositivi edge o sistemi leggeri — chiunque abbia mai pensato: "Devo solo eseguire questo modello, non ho bisogno di un intero ecosistema per farlo".
Dove andare da qui:
Il repository è aperto. I feedback sull'architettura del codice sono genuinamente benvenuti — specialmente da persone che hanno costruito sistemi simili o colpito gli stessi muri. E se questo ti risuona, una stella aiuta molto a sostenere il progetto.
```javascript
$code = @'
import pdefa
import cv2
model = pdefa.load('D:/PROJE/yolov8s.engine')
img_path = 'D:/PROJE/bus.jpg'
boxes = model(img_path, conf_thres=0.75)
img = cv2.imread(img_path)
class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}
for b in boxes:
cls = int(b['cls'])
conf = b['conf']
x1, y1 = int(b['x1']), int(b['y1'])
x2, y2 = int(b['x2']), int(b['y2'])
names_attr = getattr(model, 'names', {})
cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

label = f'{cls_name} {conf:.2f}'
cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)
print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')
cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
Benvenuto
Accedi per utilizzare l'assistente IA
Menu
Home
Tutti gli strumenti
Editor
Modifica testo e forme
Blog
Suggerimenti e guide
Ricerca
Articoli e studi accademici
Tema
Lingua
Azioni recenti
Lokal Geçmiş