CPU の限界をどこまで押し広げられるか?
肥大化したフレームワークと GPU 依存に甘んじないでください。pdefa を発見しましょう — ディープラーニングモデルを CPU 上で直接実行する、ゼロから作られた推論エンジンです。
CPU の限界をどこまで押し広げられるか?
何年もの間、「ディープラーニングを実行する」という問いへの答えは同じでした:GPU を買いなさい。しかしその答えは根本的な疑問を無視しています — そのハードウェアを実際にどれだけ使っているのか、そしてフレームワークのオーバーヘッドにどれだけ無駄にしているのか?
外部ライブラリのブロートウェアから解放され、ハードウェアの全力を最大効率で引き出すために、私のエンジニアリングの旅とオープンソースプロジェクトを共有します:pdefa (hasnard/pdefa)。
pdefa とは?
pdefa は、C++20 と AVX2 SIMD アーキテクチャを使用してゼロから構築したディープラーニング推論エンジンで、モデルを CPU 上で直接実行します — GPU 不要、重いランタイム不要、単一の推論を実行する前に解きほぐす必要のある依存関係ツリーもありません。
私の中心的な動機は単純でした:システムリソースが絶対的な効率でどのように管理できるかを体験し、この超軽量アーキテクチャを AGPL-3.0 ライセンスの下でエコシステムに提供し、真のオープンソース哲学に妥協なく忠実であり続けることです。
なぜそもそも CPU 推論にこだわるのか?
なぜなら、現実世界の展開のほとんどは専用 GPU という贅沢を持たないからです。エッジデバイス、組み込みシステム、CI パイプライン、小規模 VPS インスタンス、工場現場のマシン、学術クラスターはすべて CPU 上で動作します。これらの環境では、フレームワークのオーバーヘッドの 1 メガバイトごと、不必要な依存関係の 1 つごとがコストです — メモリ、起動時間、展開の複雑さにおいて。
十数の共有ライブラリを引き込む 300 MB のフレームワークは「無料」ではありません。それは展開のたびに支払う税金です。
主な技術ハイライト:
- 超軽量サイズ
コンパイルされたネイティブバイナリはわずか 320 KB。メガバイト単位の肥大化も、最初にインストールしなければならないランタイムもありません — 推論を実行するのに必要なものだけです。
- 外部依存ゼロ
Python インターフェースは組み込みの ctypes モジュールのみに依存します。pip install も、バージョン競合も、仮想環境の体操もありません。
- ハードウェア最適化
AVX2 命令セットを使用してベクトル化処理能力を最大化し、スレッド数を直接制御できます — 実行している正確な CPU に合わせて調整できます。
- 幅広いアーキテクチャサポート
YOLO(v8 から v12)、ResNet、MobileNet、EfficientNet、DeepLabV3 アーキテクチャをすぐに実行できます。
- 組み込み画像処理
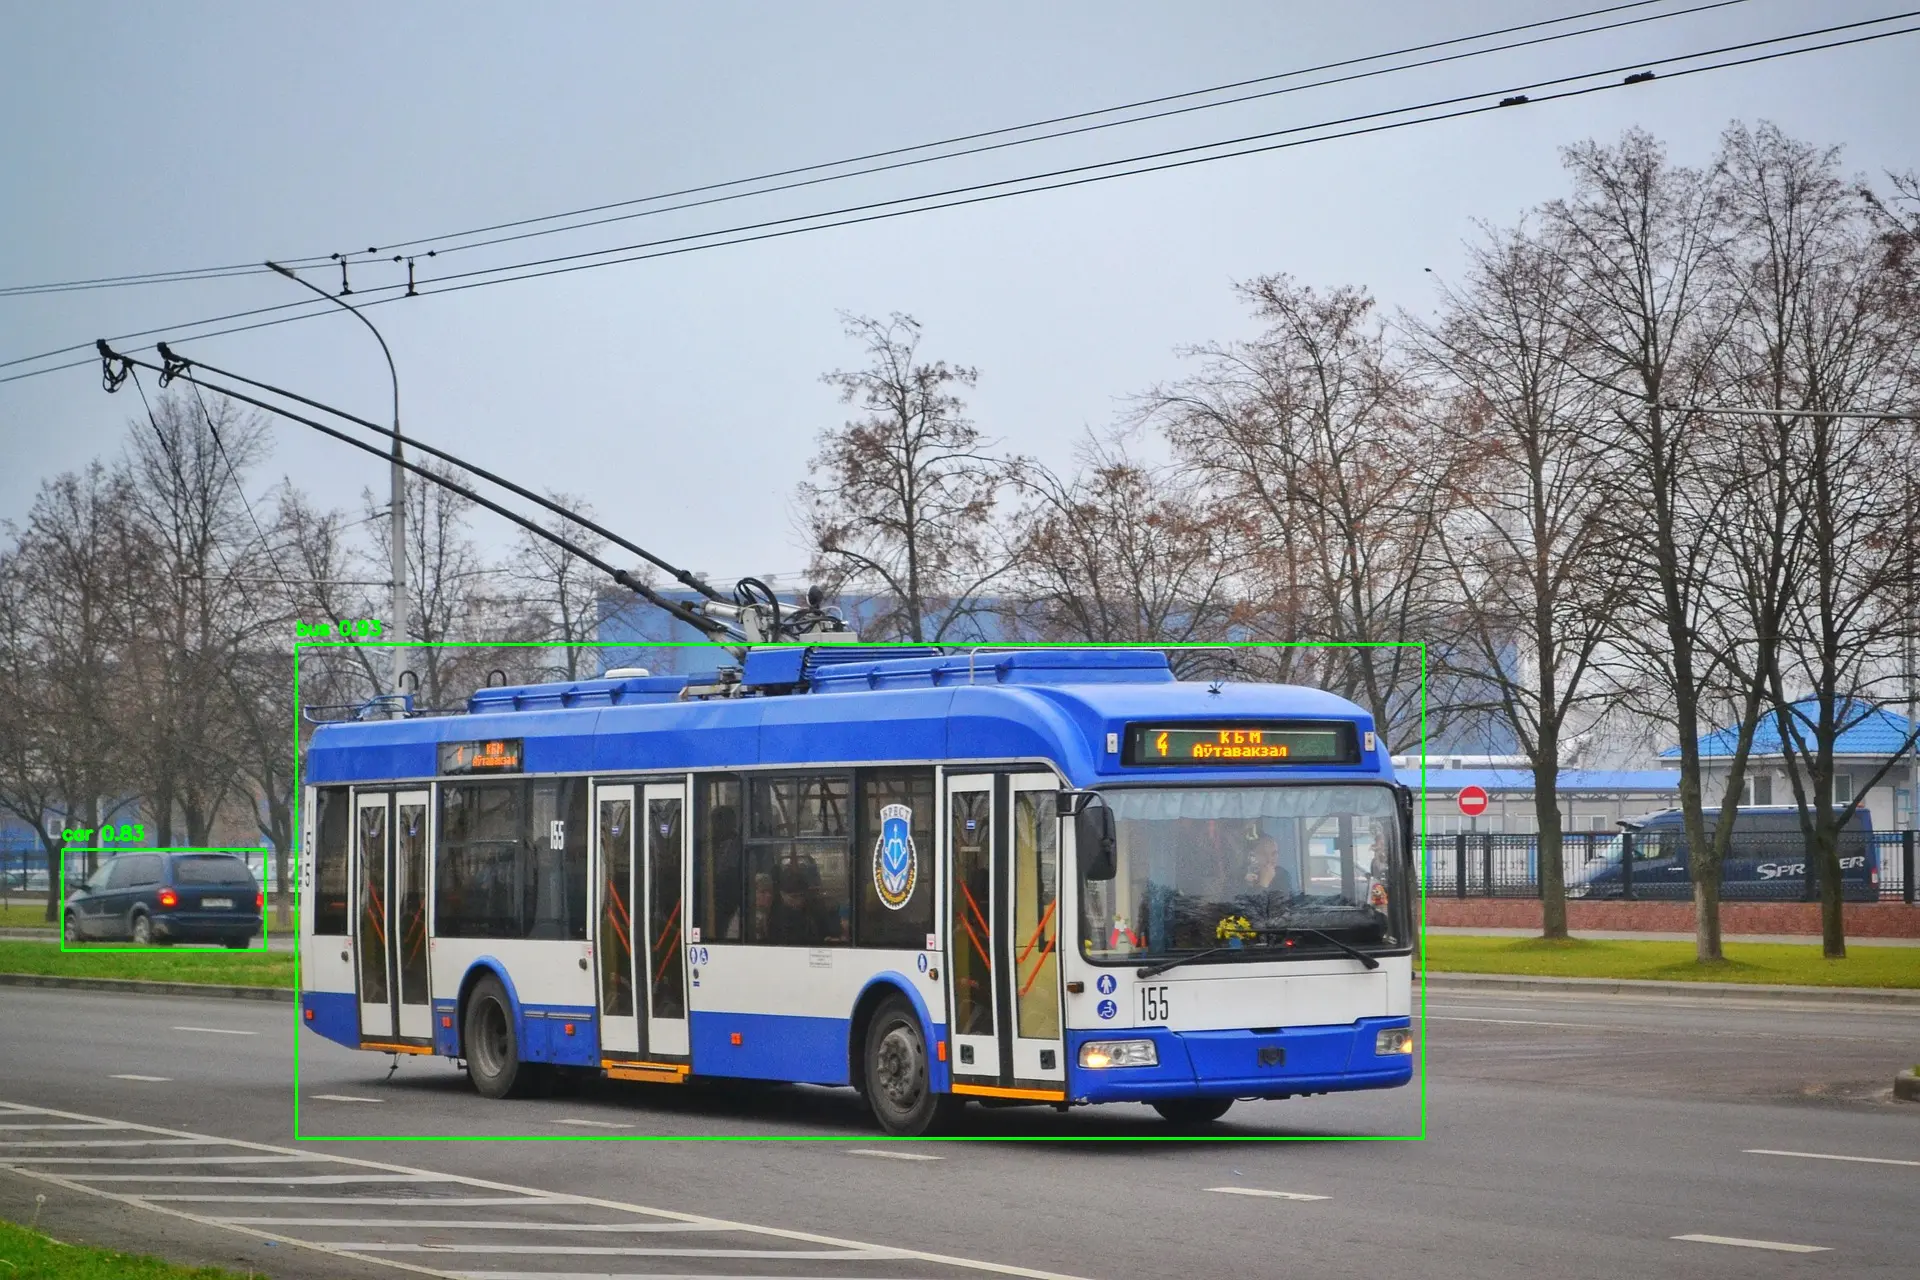
独自の PNG/JPEG ローダーと組み込みの YOLO 後処理アルゴリズムを備え、OpenCV のような重いライブラリの必要性を完全に回避します。
- 柔軟な変換ワークフロー
既存の PyTorch モデルを標準 ONNX 形式にエクスポートし、エンジン内蔵のコンバーターを使用して、pdefa 独自の低遅延 .engine 形式にシームレスに変換します。
開発ロードマップ:
まもなく pytorchtoengine ツールをリリースします。これにより PyTorch ユーザーは ONNX 中間ステップを完全に回避し、モデルをエンジンのネイティブ形式に直接変換できるようになります。ホップが 1 つ減り、デバッグするものが 1 つ減ります。
これは誰のためか:
リソースに制約のあるサーバー、エッジデバイス、または軽量システムで作業する開発者にとって強力な代替手段となることを願っています — 「このモデルを実行するだけでよく、そのためのエコシステム全体は必要ない」と考えたことがあるすべての人に。
ここからどこへ:
リポジトリはオープンです。コードアーキテクチャに関するフィードバックは心から歓迎します — 特に同様のシステムを構築した人や同じ壁にぶつかった人から。そしてこれが響くなら、スターはプロジェクトを支援する大きな力になります。
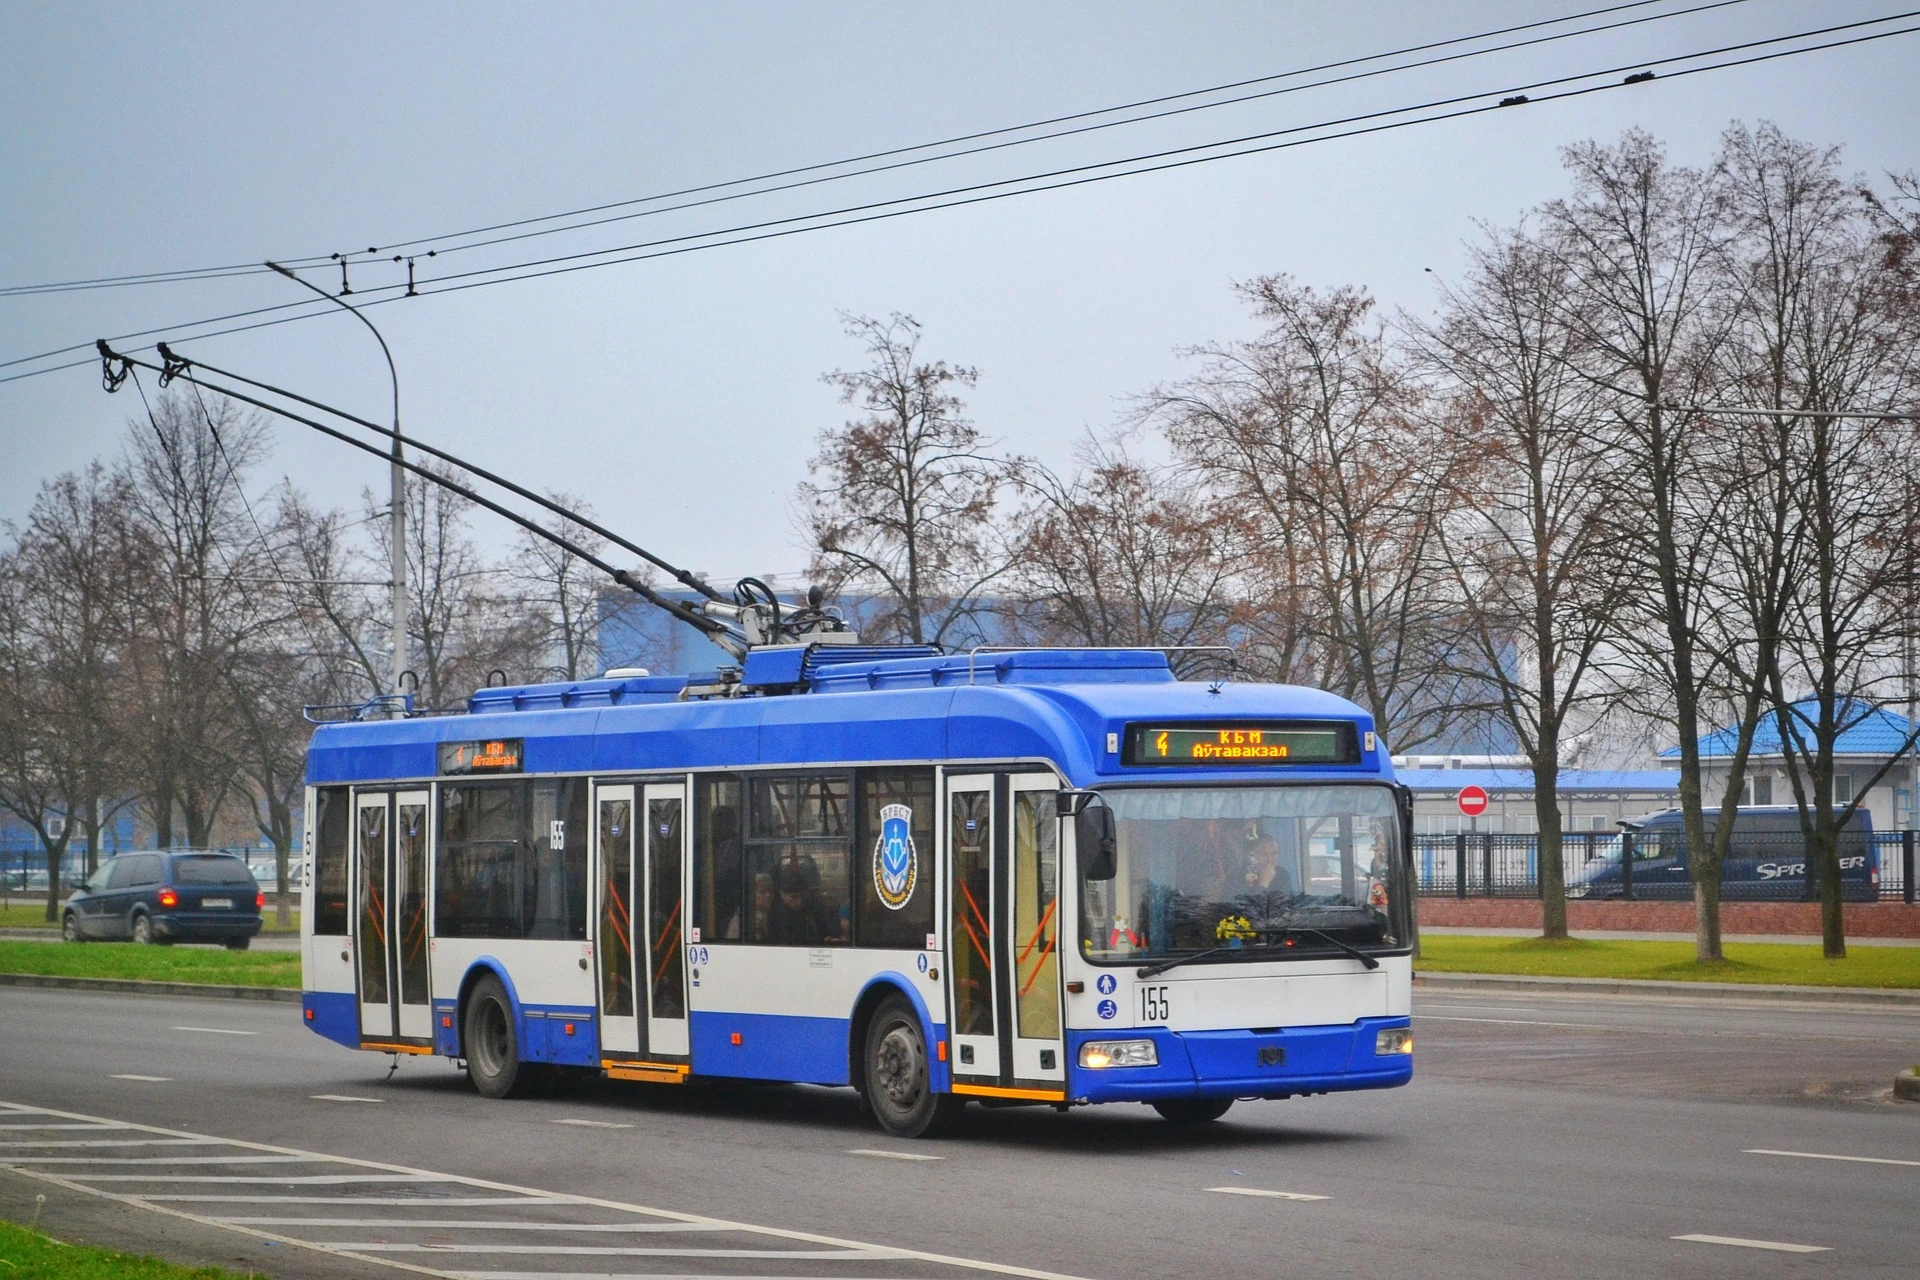
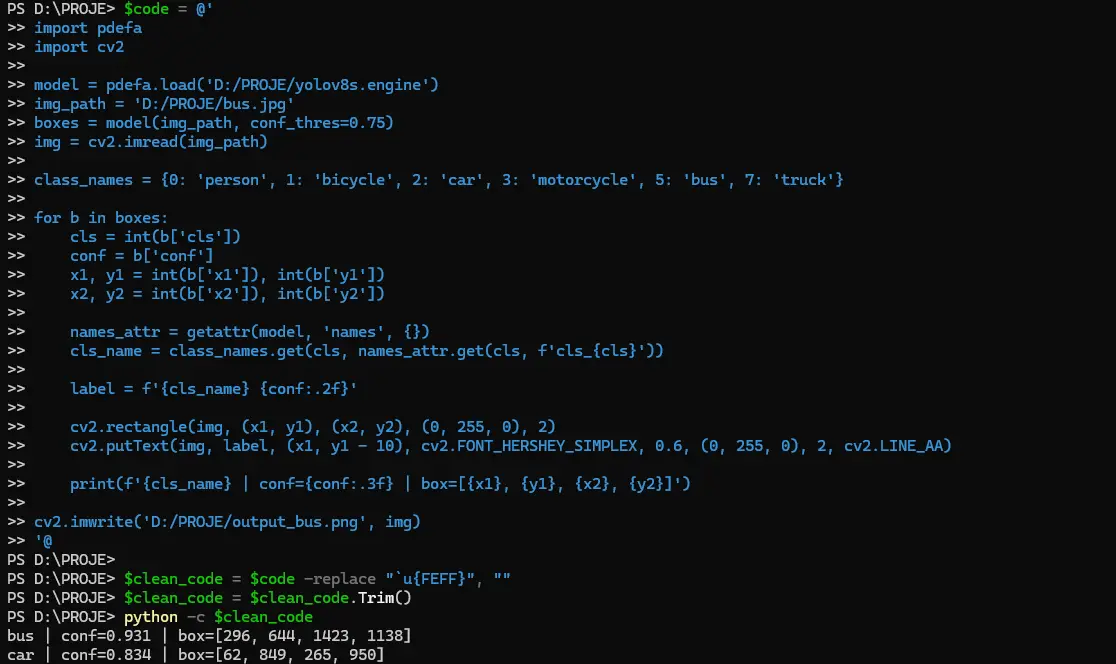
$code = @'
 import pdefa
 import cv2

 model = pdefa.load('D:/PROJE/yolov8s.engine')
 img_path = 'D:/PROJE/bus.jpg'
 boxes = model(img_path, conf_thres=0.75)
 img = cv2.imread(img_path)

 class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}

 for b in boxes:
    cls = int(b['cls'])
    conf = b['conf']
    x1, y1 = int(b['x1']), int(b['y1'])
    x2, y2 = int(b['x2']), int(b['y2'])

    names_attr = getattr(model, 'names', {})
    cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

    label = f'{cls_name} {conf:.2f}'

   cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
   cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)

print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')

cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
ようこそ
AIアシスタントを使用するにはログインしてください
最近の操作
Lokal Geçmiş