Até onde podemos empurrar os limites de uma CPU?
Não se contente com frameworks inchados e dependência de GPU. Conheça o pdefa — um motor de inferência criado do zero que executa modelos de deep learning diretamente na CPU.
Até onde podemos empurrar os limites de uma CPU?
Por anos, a resposta para "executar deep learning" tem sido a mesma: compre uma GPU. Mas essa resposta ignora uma questão fundamental — quanto desse hardware estamos realmente usando e quanto estamos desperdiçando em sobrecarga de framework?
Para nos libertarmos do bloatware de bibliotecas externas e aproveitar todo o poder do hardware com máxima eficiência, compartilho minha jornada de engenharia e meu projeto de código aberto: pdefa (hasnard/pdefa).
O que é pdefa?
pdefa é um motor de inferência de deep learning que construí do zero usando C++20 e arquitetura SIMD AVX2 para executar modelos diretamente na CPU — sem GPU necessária, sem runtime pesado, sem árvore de dependências para desembaraçar antes de poder executar uma única inferência.
Minha motivação principal era simples: experimentar como os recursos do sistema podem ser gerenciados com eficiência absoluta e trazer essa arquitetura ultraleve para o ecossistema sob a licença AGPL-3.0, mantendo-me sem concessões fiel à verdadeira filosofia open source.
Por que se preocupar com inferência em CPU?
Porque a maioria das implantações do mundo real não tem o luxo de uma GPU dedicada. Dispositivos de borda, sistemas embarcados, pipelines de CI, pequenas instâncias VPS, máquinas de fábrica e clusters acadêmicos funcionam todos em CPU. Nesses ambientes, cada megabyte de sobrecarga de framework e cada dependência desnecessária é um custo — em memória, em tempo de inicialização, em complexidade de implantação.
Um framework de 300 MB que puxa uma dúzia de bibliotecas compartilhadas não é "gratuito". É um imposto que você paga em cada implantação.
Destaques técnicos principais:
- Tamanho ultraleve
O binário nativo compilado tem apenas 320 KB. Sem megabytes de inchaço, sem runtime que você precise instalar primeiro — apenas o necessário para executar a inferência.
- Zero dependências externas
A interface Python depende unicamente do módulo ctypes embutido. Sem pip install, sem conflitos de versão, sem ginástica de ambiente virtual.
- Otimização de hardware
Maximiza a capacidade de processamento vetorizado usando conjuntos de instruções AVX2 e dá controle direto sobre o número de threads — para que você possa ajustá-lo exatamente à CPU em que está executando.
- Amplo suporte de arquiteturas
Capaz de executar YOLO (v8 a v12), ResNet, MobileNet, EfficientNet e DeepLabV3 prontos para uso.
- Processamento de imagem integrado
Possui seu próprio carregador PNG/JPEG e um algoritmo de pós-processamento YOLO integrado, contornando completamente a necessidade de bibliotecas pesadas como OpenCV.
- Fluxo de conversão flexível
Exporte seus modelos PyTorch existentes para o formato ONNX padrão e, em seguida, use o conversor integrado do motor para traduzi-los perfeitamente para o formato .engine personalizado de baixa latência do pdefa.
Roteiro de desenvolvimento:
Em breve lançarei a ferramenta pytorchtoengine, que permitirá aos usuários do PyTorch ignorar completamente a etapa intermediária do ONNX e converter modelos diretamente para o formato nativo do motor. Um salto a menos, uma coisa a menos para depurar.
Para quem é isto:
Espero que isto sirva como uma alternativa poderosa para desenvolvedores que trabalham com servidores de recursos limitados, dispositivos de borda ou sistemas leves — qualquer um que já tenha pensado: "Eu só preciso executar este modelo, não preciso de um ecossistema inteiro para isso."
Para onde ir a partir daqui:
O repositório está aberto. Feedback sobre a arquitetura do código é genuinamente bem-vindo — especialmente de pessoas que construíram sistemas semelhantes ou bateram nas mesmas paredes. E se isto ressoar com você, uma estrela ajuda muito a apoiar o projeto.
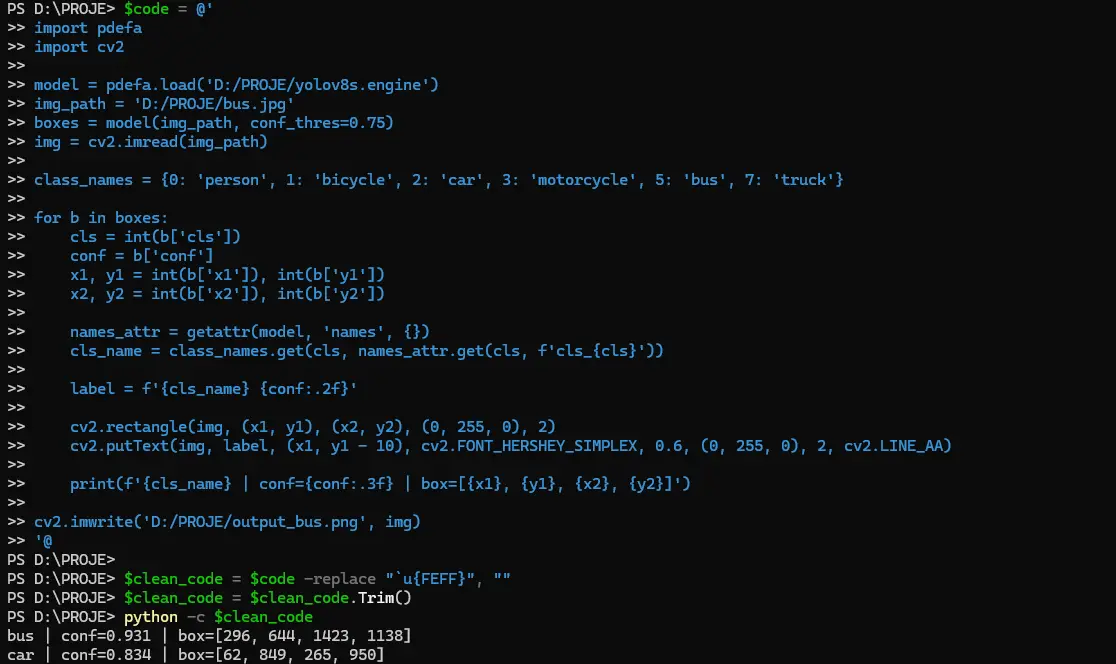
$code = @'
 import pdefa
 import cv2

 model = pdefa.load('D:/PROJE/yolov8s.engine')
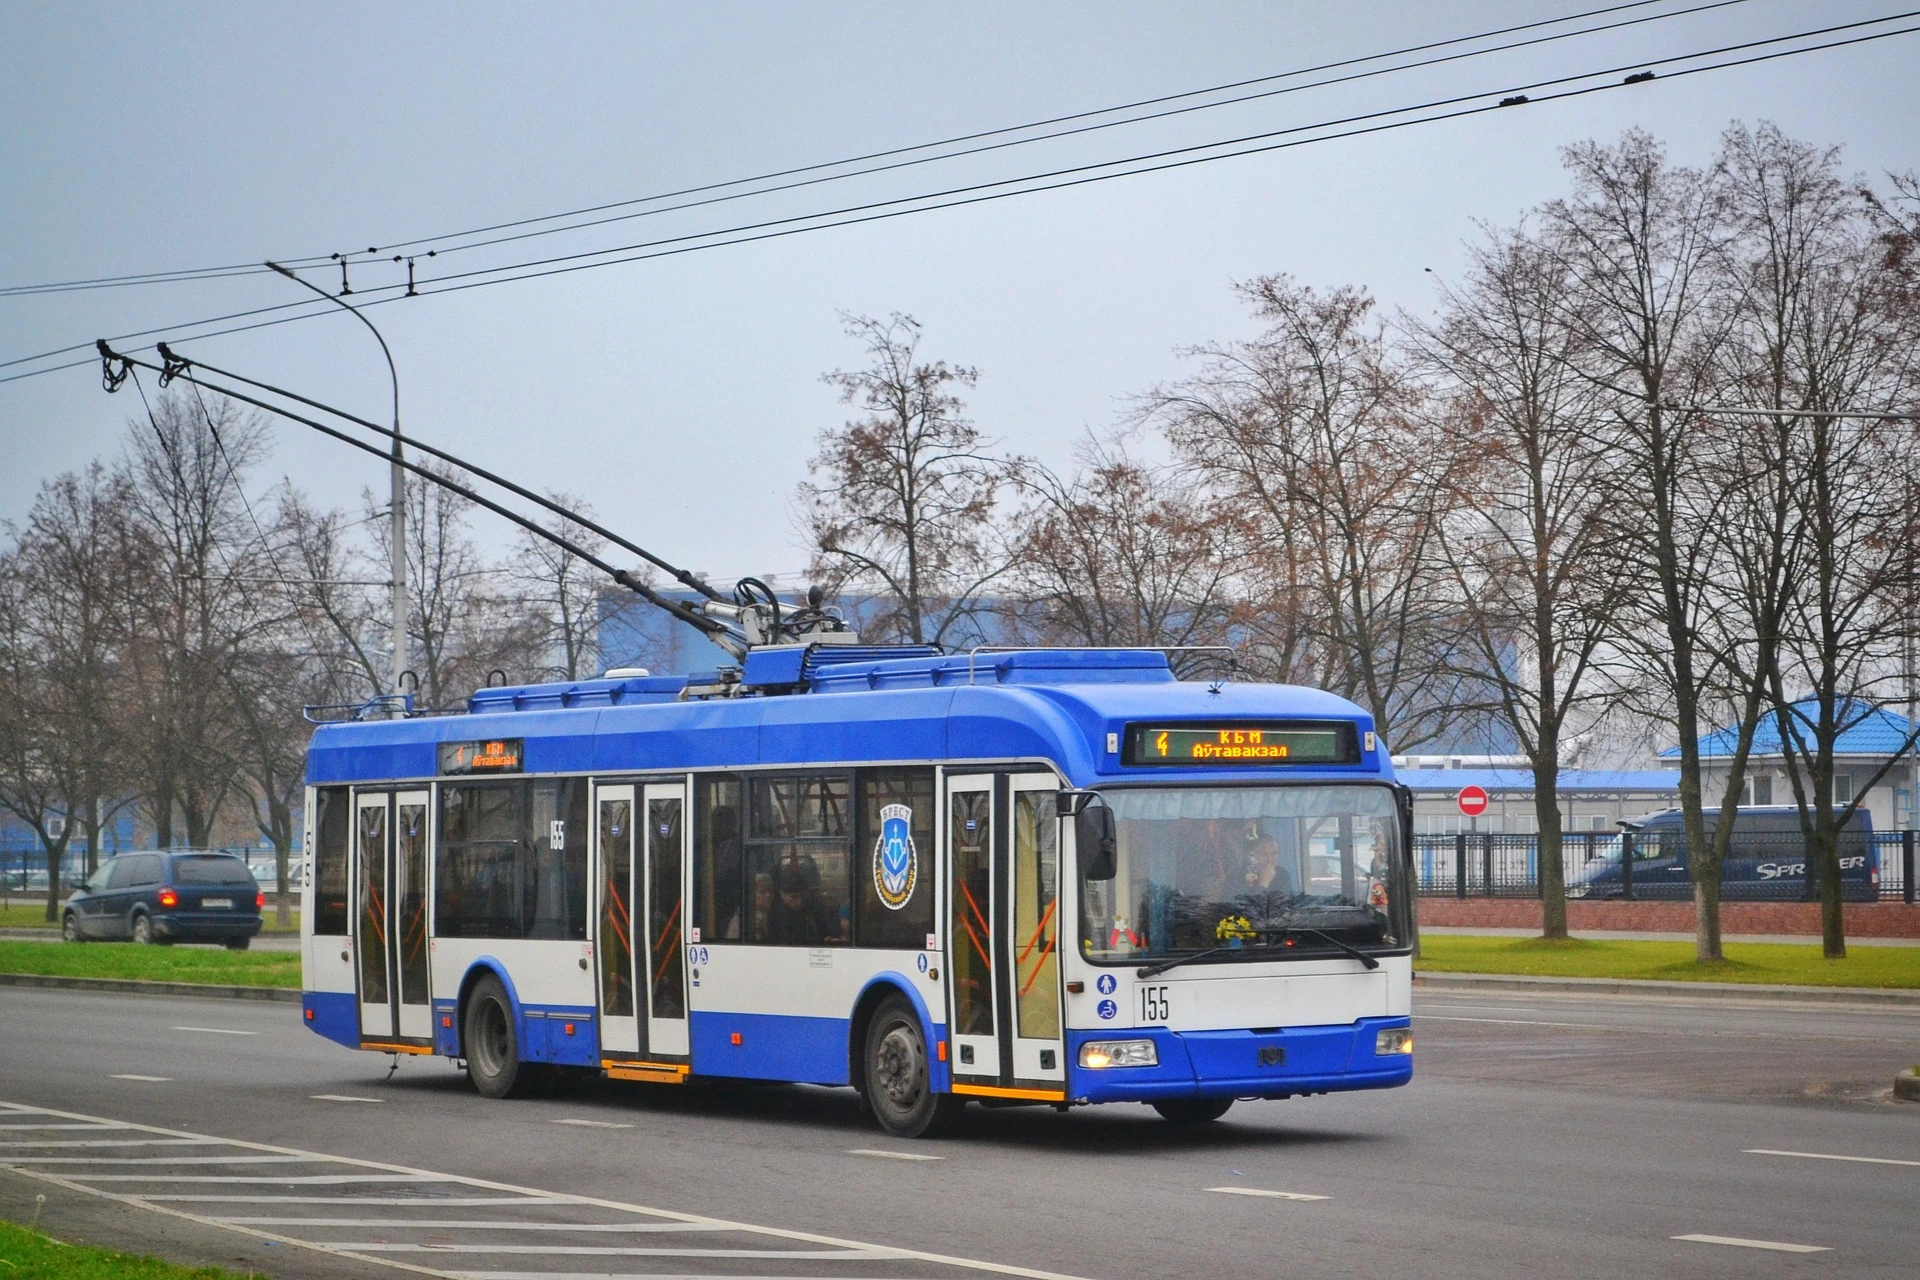
 img_path = 'D:/PROJE/bus.jpg'
 boxes = model(img_path, conf_thres=0.75)
 img = cv2.imread(img_path)

 class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}

 for b in boxes:
    cls = int(b['cls'])
    conf = b['conf']
    x1, y1 = int(b['x1']), int(b['y1'])
    x2, y2 = int(b['x2']), int(b['y2'])

    names_attr = getattr(model, 'names', {})
    cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

    label = f'{cls_name} {conf:.2f}'

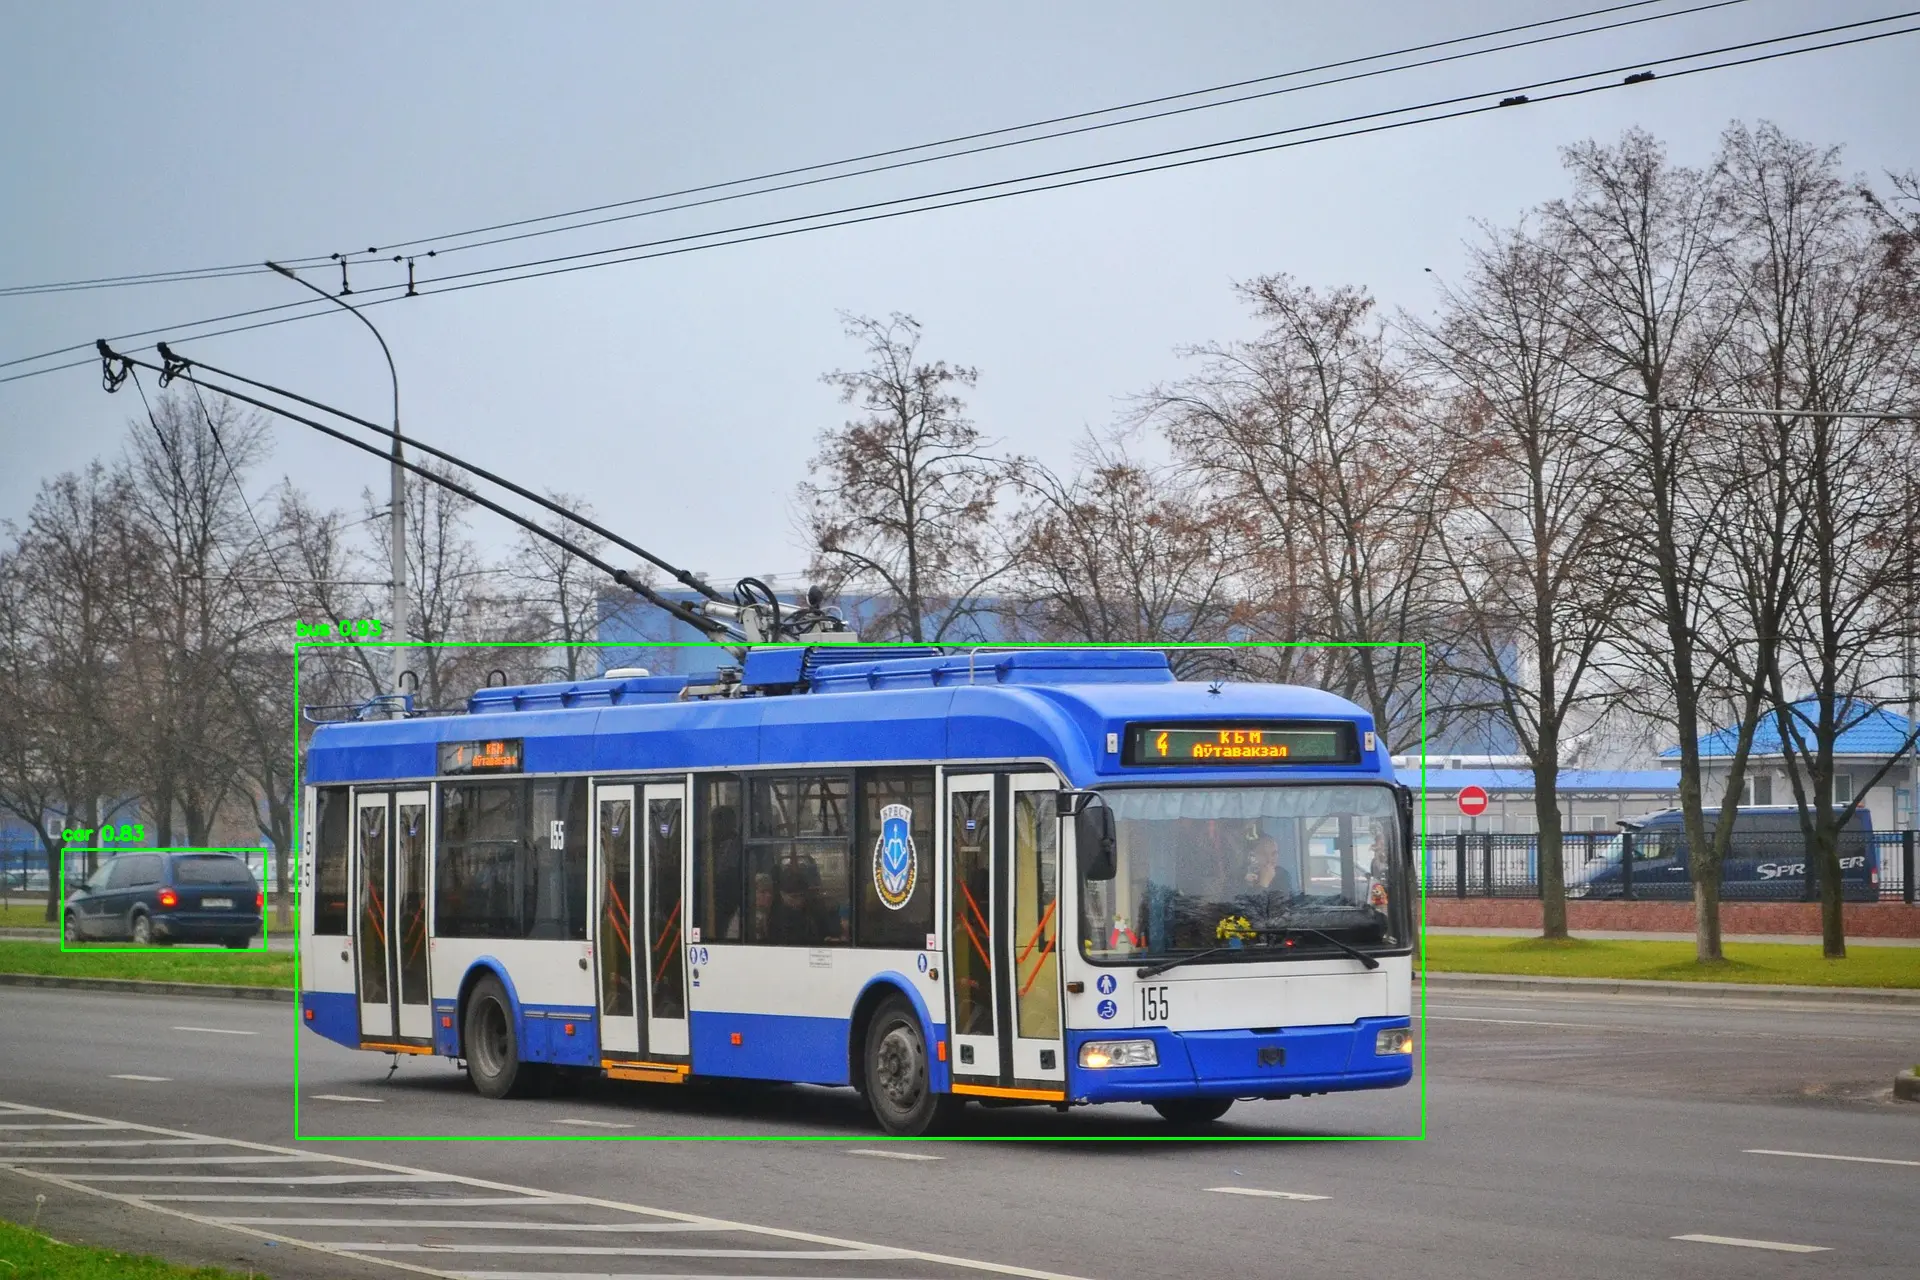
   cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
   cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)

print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')

cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
Bem-vindo
Faça login para usar o assistente de IA
Menu
Início
Todas as ferramentas
Editor
Editar texto e formas
Blog
Dicas e guias
Pesquisa
Artigos e estudos acadêmicos
Tema
Idioma
Ações recentes
Lokal Geçmiş