Jusqu'où pouvons-nous repousser les limites d'un CPU ?
Ne vous contentez pas de frameworks gonflés et d'une dépendance au GPU. Découvrez pdefa — un moteur d'inférence conçu de zéro qui exécute des modèles de deep learning directement sur le CPU.
Jusqu'où pouvons-nous repousser les limites d'un CPU ?
Pendant des années, la réponse à « exécuter du deep learning » a été la même : achetez un GPU. Mais cette réponse ignore une question fondamentale — quelle part de ce matériel utilisons-nous réellement, et quelle part gaspillons-nous en surcharge de framework ?
Pour nous libérer des logiciels gonflés des bibliothèques externes et exploiter toute la puissance du matériel avec une efficacité maximale, je partage mon parcours d'ingénierie et mon projet open source : pdefa (hasnard/pdefa).
Qu'est-ce que pdefa ?
pdefa est un moteur d'inférence de deep learning que j'ai construit de zéro en utilisant C++20 et l'architecture SIMD AVX2 pour exécuter des modèles directement sur le CPU — aucun GPU requis, aucun environnement d'exécution lourd, aucun arbre de dépendances à démêler avant de pouvoir exécuter une seule inférence.
Ma motivation principale était simple : expérimenter comment les ressources système peuvent être gérées avec une efficacité absolue, et apporter cette architecture ultra-légère à l'écosystème sous licence AGPL-3.0, en restant sans compromis fidèle à la véritable philosophie open source.
Pourquoi s'embêter avec l'inférence sur CPU ?
Parce que la plupart des déploiements réels n'ont pas le luxe d'un GPU dédié. Les appareils en périphérie, les systèmes embarqués, les pipelines CI, les petites instances VPS, les machines d'atelier et les clusters académiques fonctionnent tous sur CPU. Dans ces environnements, chaque mégaoctet de surcharge de framework et chaque dépendance inutile est un coût — en mémoire, en temps de démarrage, en complexité de déploiement.
Un framework de 300 Mo qui tire une douzaine de bibliothèques partagées n'est pas « gratuit ». C'est une taxe que vous payez à chaque déploiement.
Principaux atouts techniques :
- Taille ultra-légère
Le binaire natif compilé ne fait que 320 Ko. Pas de mégaoctets de ballast, pas d'environnement d'exécution à installer au préalable — juste ce qu'il faut pour exécuter l'inférence.
- Zéro dépendance externe
L'interface Python repose uniquement sur le module ctypes intégré. Pas de pip install, pas de conflits de versions, pas de gymnastique d'environnement virtuel.
- Optimisation matérielle
Maximise la capacité de traitement vectorisé en utilisant les jeux d'instructions AVX2 et donne un contrôle direct sur le nombre de threads — afin que vous puissiez l'ajuster exactement au CPU sur lequel vous travaillez.
- Large support d'architectures
Capable d'exécuter YOLO (v8 à v12), ResNet, MobileNet, EfficientNet et DeepLabV3 nativement.
- Traitement d'image intégré
Dispose de son propre chargeur PNG/JPEG et d'un algorithme de post-traitement YOLO intégré, contournant complètement le besoin de bibliothèques lourdes comme OpenCV.
- Flux de conversion flexible
Exportez vos modèles PyTorch existants au format ONNX standard, puis utilisez le convertisseur intégré du moteur pour les traduire de manière transparente au format .engine personnalisé à faible latence de pdefa.
Feuille de route de développement :
Je publierai bientôt l'outil pytorchtoengine, qui permettra aux utilisateurs de PyTorch de contourner entièrement l'étape intermédiaire ONNX et de convertir les modèles directement au format natif du moteur. Une étape de moins, une chose de moins à déboguer.
À qui cela s'adresse :
J'espère que cela constituera une alternative puissante pour les développeurs travaillant avec des serveurs à ressources limitées, des appareils en périphérie ou des systèmes légers — tous ceux qui ont déjà pensé : « J'ai juste besoin d'exécuter ce modèle, je n'ai pas besoin de tout un écosystème pour cela. »
Où aller à partir d'ici :
Le dépôt est ouvert. Les retours sur l'architecture du code sont vraiment bienvenus — en particulier de la part de personnes qui ont construit des systèmes similaires ou heurté les mêmes murs. Et si cela vous parle, une étoile contribue grandement à soutenir le projet.
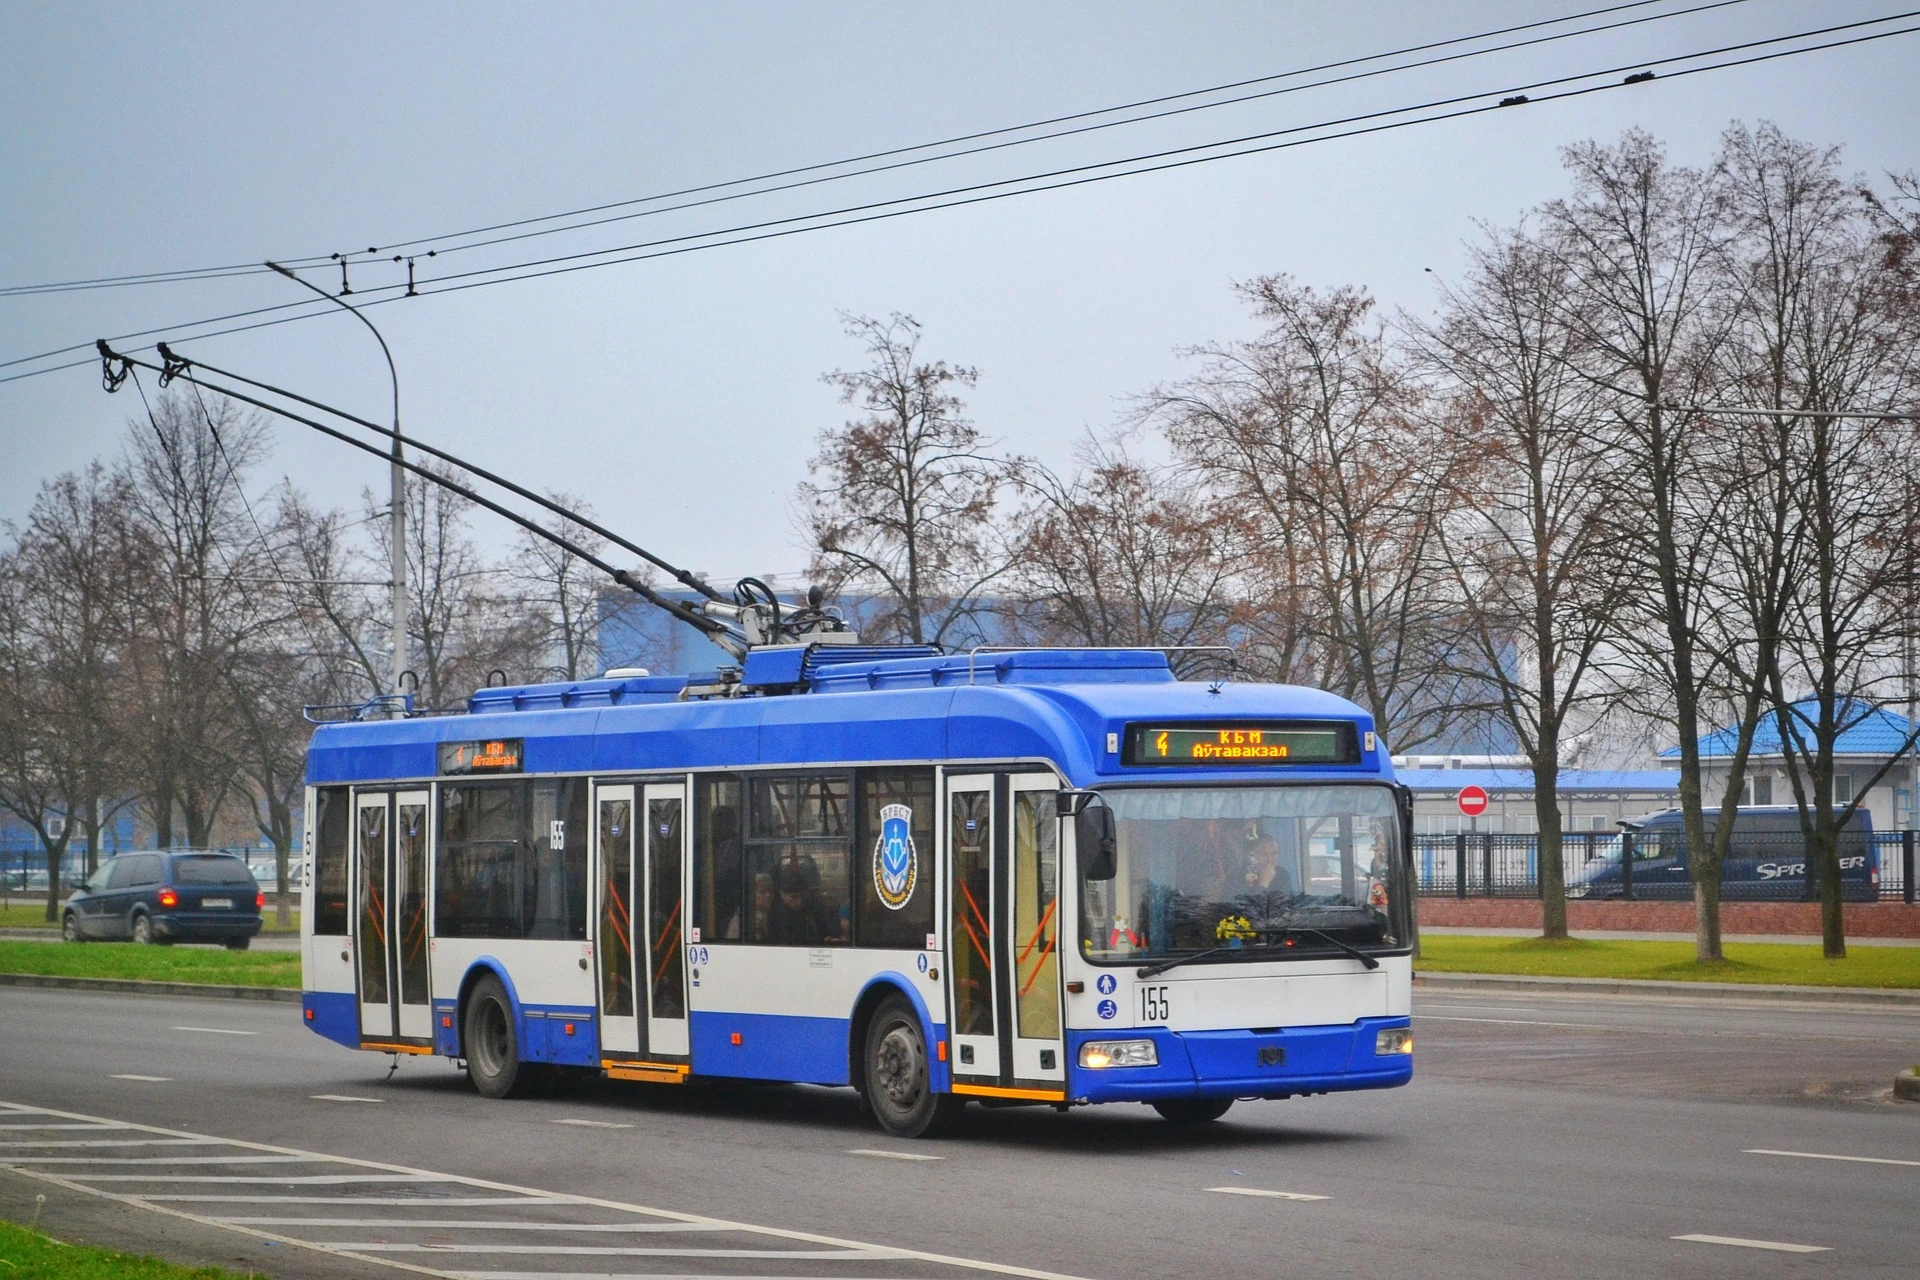
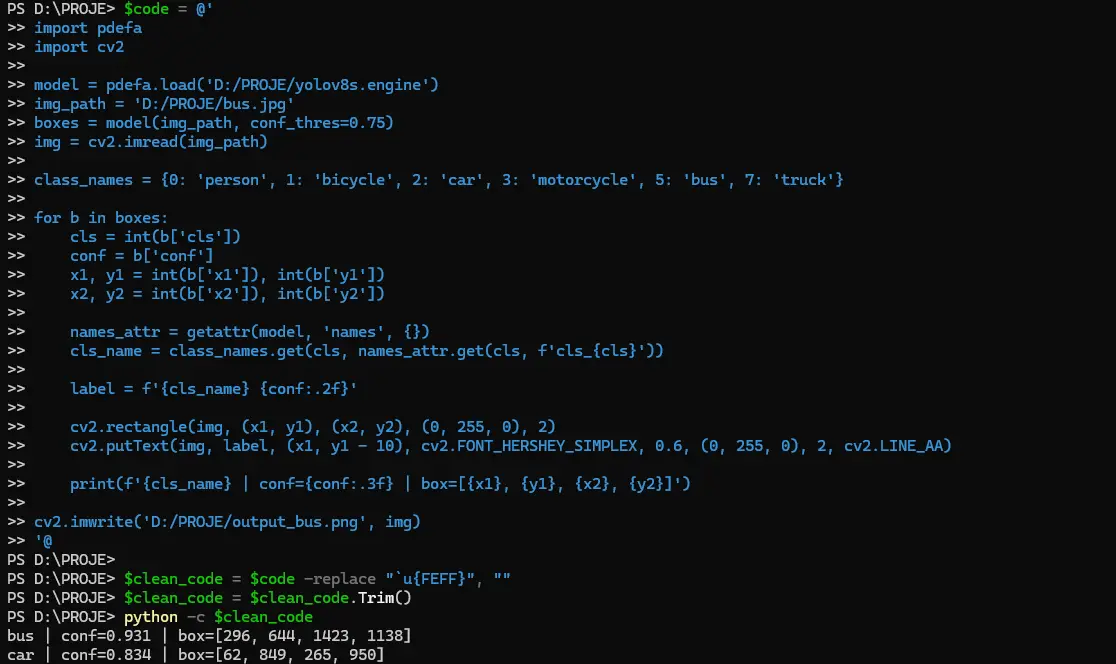
$code = @'
 import pdefa
 import cv2

 model = pdefa.load('D:/PROJE/yolov8s.engine')
 img_path = 'D:/PROJE/bus.jpg'
 boxes = model(img_path, conf_thres=0.75)
 img = cv2.imread(img_path)

 class_names = {0: 'person', 1: 'bicycle', 2: 'car', 3: 'motorcycle', 5: 'bus', 7: 'truck'}

 for b in boxes:
    cls = int(b['cls'])
    conf = b['conf']
    x1, y1 = int(b['x1']), int(b['y1'])
    x2, y2 = int(b['x2']), int(b['y2'])

    names_attr = getattr(model, 'names', {})
    cls_name = class_names.get(cls, names_attr.get(cls, f'cls_{cls}'))

    label = f'{cls_name} {conf:.2f}'

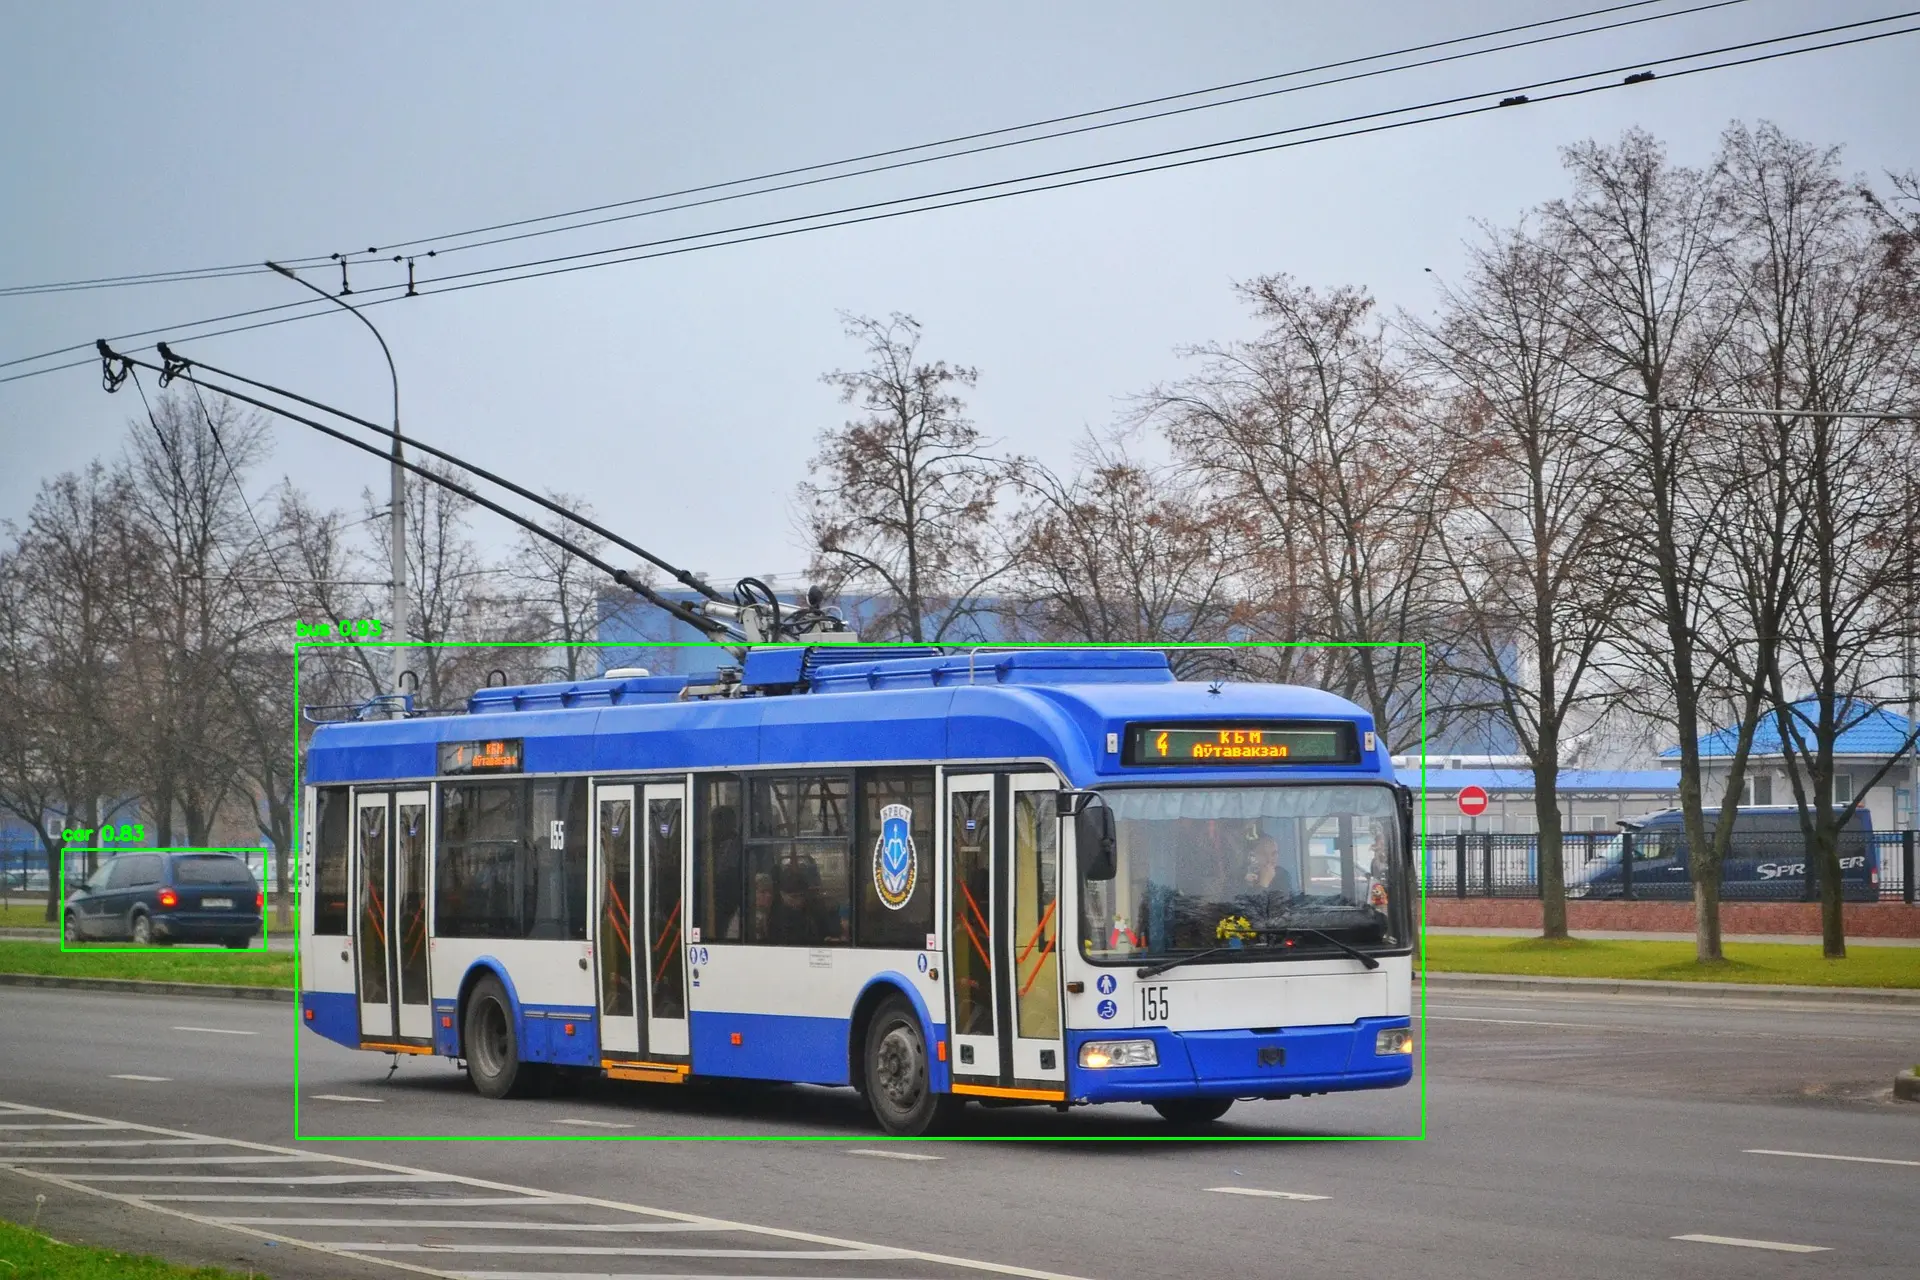
   cv2.rectangle(img, (x1, y1), (x2, y2), (0, 255, 0), 2)
   cv2.putText(img, label, (x1, y1 - 10), cv2.FONT_HERSHEY_SIMPLEX, 0.6, (0, 255, 0), 2, cv2.LINE_AA)

print(f'{cls_name} | conf={conf:.3f} | box=[{x1}, {y1}, {x2}, {y2}]')

cv2.imwrite('D:/PROJE/output_bus.png', img)
'@
Vous aimerez peut-être aussi
Voir tout
Bienvenue
Connectez-vous pour utiliser l’assistant IA
Menu
Accueil
Tous les outils
Éditeur
Éditer du texte et des formes
Blog
Conseils et guides
Recherche
Articles et études académiques
Thème
Langue
Actions récentes
Lokal Geçmiş